บทที่ 1: ทำไม Session เดียวไม่พอ — และทำไมไม่ใช่ทุกงานต้องมีหลาย Agent
คุณมีงานตรงหน้า อาจเป็นฟีเจอร์ที่แตะทั้ง backend กับหน้าเว็บ แผนที่มีหลายเฟส เอกสาร API ทั้งชุด log ของ incident ที่ชี้ไปคนละทาง หรือแค่ PR หนึ่งอัน Claude Code ทำได้ทั้งสี่แบบ: คนเดียวใน session เดียว ส่ง subagent ไปช่วย เขียนเป็น workflow ที่สคริปต์ถือแผน หรือตั้งเป็นทีมที่คุยกันเอง คำตอบที่ถูกขึ้นกับว่างานนั้นต้องการอะไร: context หลักที่เบาและงานย่อยที่เริ่มจากหน้าว่าง, ลูปและเงื่อนไขหยุดที่อยู่ในโค้ด ทำโดยไม่มีคนเฝ้าและทำซ้ำได้, ประตูตรวจที่เครื่องรันได้, หรือคนในห้องที่ท้าทายกัน หนังสือเล่มนี้เอางานจริงมารันทีละงานบน Claude Code v2.1.296 บอกว่าวิธีไหนเหมาะกับงานไหน พร้อมเวลา ค่าใช้จ่าย และสิ่งที่พัง และบอกด้วยว่างานไหนไม่ควรใช้หลาย agent เลย
คำศัพท์ที่ใช้ทั้งเล่ม
- Session หลัก — Claude Code ที่คุณพิมพ์คุยด้วย
- Subagent — ผู้ช่วยที่ session หลักเรียกผ่าน Agent tool ทำงานใน context ของตัวเองแล้วส่งบทสรุปกลับ (บทที่ 4)
- Workflow — สคริปต์ JavaScript ที่ Claude เขียนและ runtime รัน เพื่อสั่ง agent จำนวนมากตามแผนที่อยู่ในโค้ด (บทที่ 5–6)
- Agent team — session หลักที่เป็น lead คุม teammate หลายคนที่คุยกันเองได้ (บทที่ 7)
- Agent definition — ไฟล์ใน
.claude/agents/ที่กำหนดตำแหน่งงาน ใช้ได้ทั้งสามวิธี (บทที่ 3) - Context — ทุกอย่างที่ agent ตัวหนึ่งเห็นในคำขอหนึ่งครั้ง วัดเป็น token
ตัวเลขทั้งเล่มมาจากการรันจริงบน Claude Code v2.1.296 (ตุลาคม 2026) model หลักคือ Opus 5.5 ที่ระดับ effort ปกติ ราคาคิดที่ list price ของ API ณ วันที่ทดลอง ถ้าคุณใช้ subscription ตัวเลขดอลลาร์คือสัดส่วนที่ไปกินโควตา ไม่ใช่เงินที่จ่าย รายละเอียดที่ผูกกับเวอร์ชัน เช่น ชื่อ setting เวอร์ชันขั้นต่ำ และคีย์ลัด รวมอยู่ในภาคผนวก D
ป้ายที่ใช้ในเล่ม ตัวอย่าง คำสั่ง และหน้าจอในเล่มมีสามที่มา และเราติดป้ายบอกไว้ทุกจุดที่ไม่ใช่ผลรันจริง ข้อความที่ไม่มีป้ายคือสิ่งที่เรารันหรือเห็นเองบน v2.1.296 (บทที่มีหัวข้อ "ทดลองก่อนเขียน" เก็บผลดิบไว้ในห้องทดลองของเล่ม) (ตาม docs ไม่ได้ทดลอง) คือพฤติกรรมที่อ่านจากเอกสารของ Claude Code ที่ตรวจเมื่อ 10 ต.ค. 2026 แต่เราไม่ได้ลองเอง (ตัวอย่างประกอบ ไม่ได้รันจริง) คือโค้ด prompt หรือหน้าจอที่เขียนขึ้นเพื่ออธิบาย ตัวเลขในนั้นไม่ใช่ผลวัด ภาคผนวก D ใช้เครื่องหมาย ✔ (ทดสอบแล้ว) กับ § (ตาม docs) ในตารางแทน
1.1 ข้อจำกัดของ session เดียว
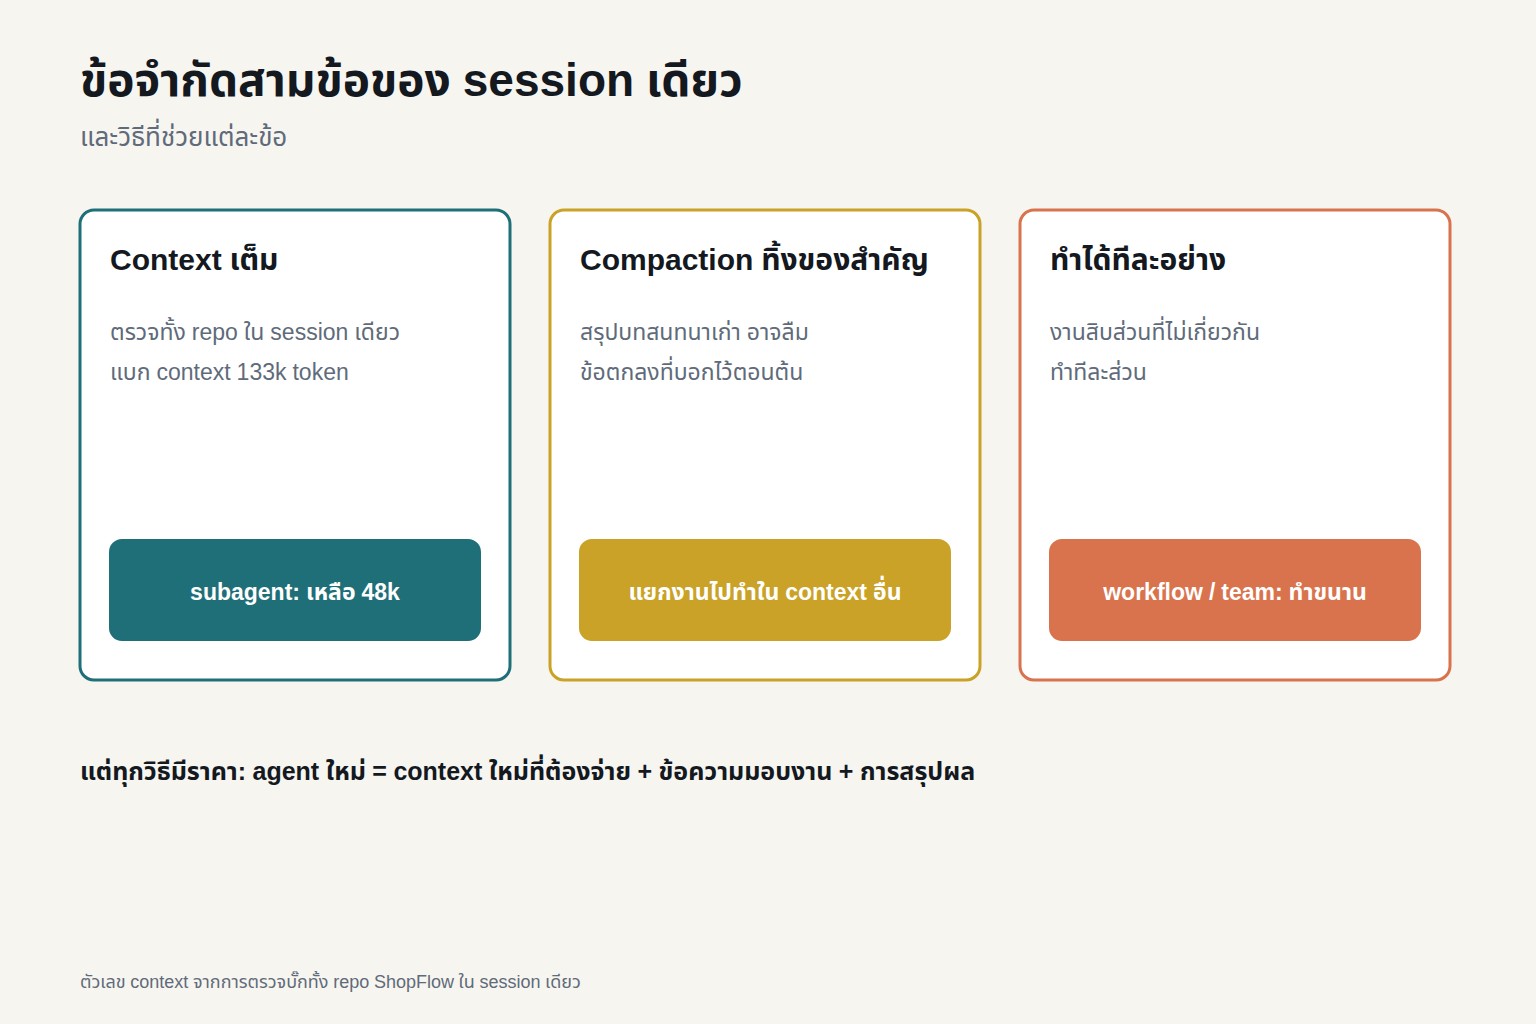
Context เต็ม
ทุกไฟล์ที่ Claude อ่าน ทุกผลของคำสั่งที่รัน และทุกข้อความที่คุยกัน สะสมอยู่ใน context ของ session ในการทดลองตรวจบั๊กทั้ง repo ShopFlow (TypeScript ราว 3,500 บรรทัด) session เดียวต้องแบก context ถึง 133,000 token ในคำขอที่ใหญ่ที่สุด ถ้างานนี้เป็นแค่ขั้นแรก ตรวจเสร็จแล้วยังต้องแก้ เขียนเทสต์ และอธิบายให้ทีมฟังต่อ ทุกขั้นถัดไปจะเริ่มจาก context ที่หนักอยู่แล้ว
Compaction ทิ้งของสำคัญ
เมื่อ context ใกล้เต็ม Claude Code จะสรุปบทสนทนาเก่าให้สั้นลง (compaction) สิ่งที่ถูกสรุปทิ้งอาจเป็นข้อตกลงที่คุณบอกไว้ตั้งแต่ต้น เช่น "ห้ามแตะโฟลเดอร์ legacy" หรือ "เงินเป็นสตางค์จำนวนเต็มเสมอ" (ข้อนี้เป็นความเสี่ยงโดยทั่วไป เราไม่ได้ทดลองให้เห็น) การแบ่งงานออกไปทำใน context อื่นช่วยให้ session หลักไม่ต้องแบกรายละเอียดเหล่านั้นตั้งแต่แรก
ทำได้ทีละอย่าง
session เดียวคิดทีละ turn ถ้างานแตกเป็นสิบส่วนที่ไม่เกี่ยวกัน มันก็ทำทีละส่วน งานที่ขนานได้จริง เช่น ตรวจทุก route ย้ายทุกไฟล์ legacy หรือแก้ error ของ typecheck หลายร้อยจุด จะเร็วขึ้นมากเมื่อแบ่งให้หลาย agent ทำพร้อมกัน
1.2 จาก "คนเขียนโค้ด" เป็น "คนออกแบบงาน"
เมื่อทำงานกับ agent หลายตัว งานของคุณเปลี่ยนจากการบอกว่า "แก้ไฟล์นี้" เป็นการตัดสินใจว่า
- งานนี้แตกเป็นชิ้นอย่างไร ชิ้นไหนทำพร้อมกันได้ ชิ้นไหนต้องรอกัน
- แต่ละชิ้นต้องรู้อะไรบ้าง เพราะ agent แต่ละตัวไม่เห็นบทสนทนาของคุณ (บทที่ 2)
- ใครถือแผน Claude ตัดสินทีละ turn, สคริปต์กำหนดไว้ล่วงหน้า หรือ lead ที่คุมทีมซึ่งคุยกันเอง
- อะไรคือ "เสร็จ" เทสต์เขียว, ผ่านการตรวจหักล้าง, ทุกคนในทีมอนุมัติ
- จ่ายได้เท่าไหร่ เพราะทุก agent ที่เพิ่มคือ context อีกก้อนที่ต้องจ่าย
คนที่ได้ประโยชน์จาก multi-agent มากที่สุดไม่ใช่คนที่สั่งให้ Claude "ใช้ agent เยอะ ๆ" แต่เป็นคนที่ออกแบบงานได้ดีพอจะรู้ว่าเมื่อไหร่ไม่ควรใช้
1.3 สามวิธีในหนึ่งภาพ
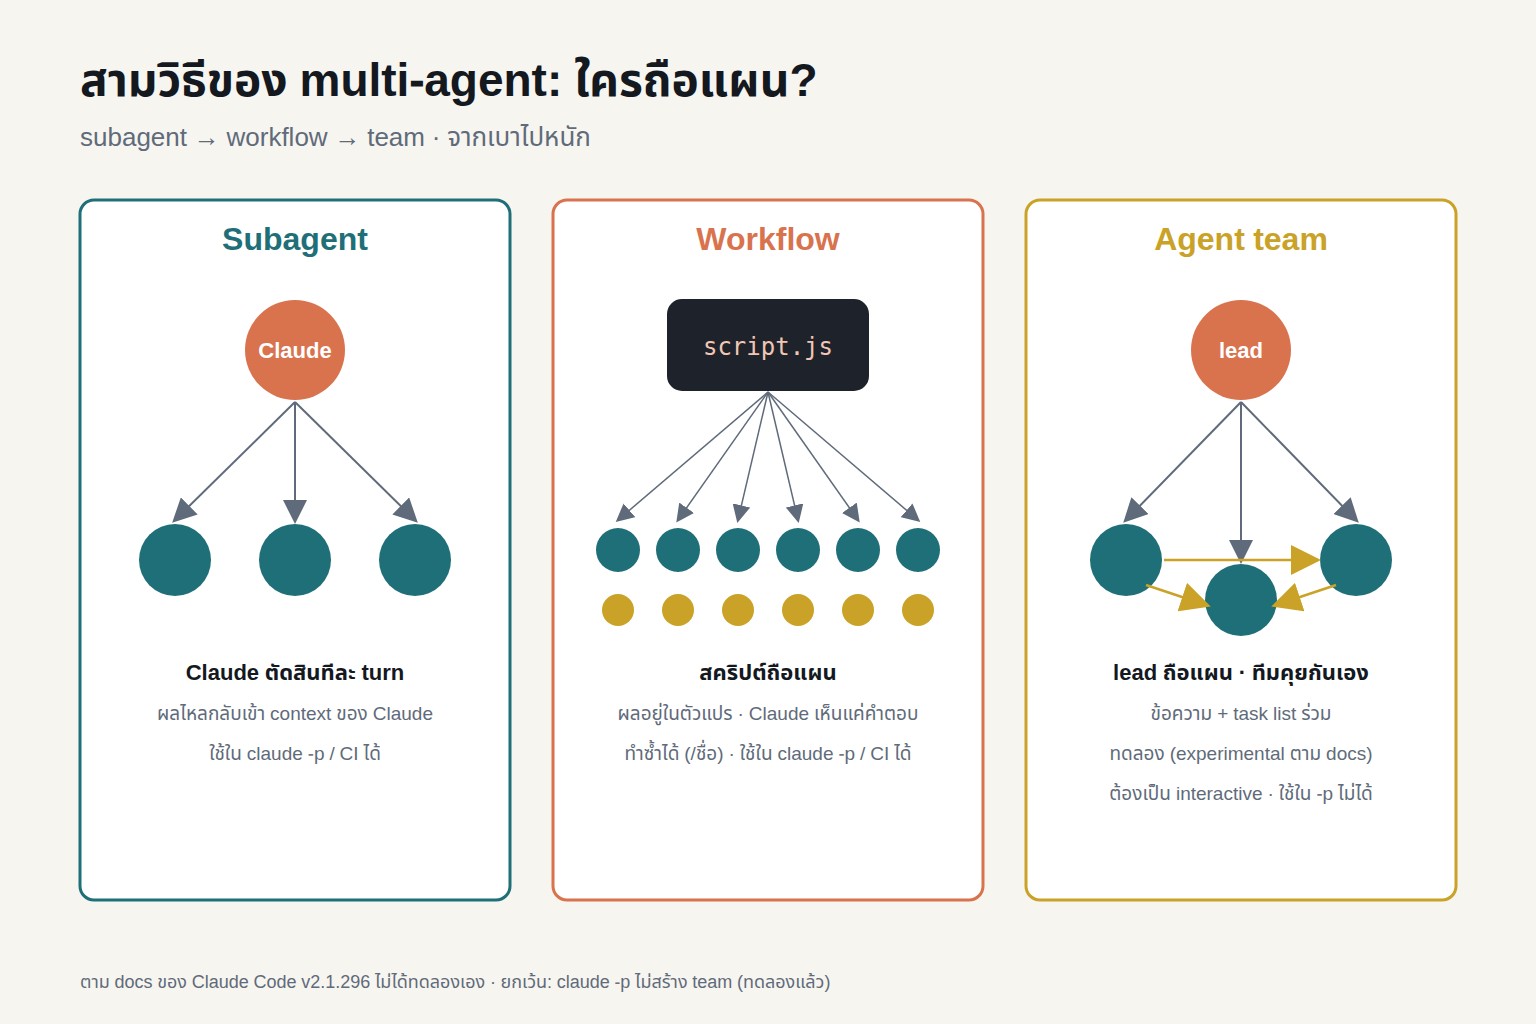
Claude Code ทำงานแบบหลาย agent ได้สามวิธีหลัก คำถามเดียวที่แยกทั้งสามออกจากกันคือ ใครถือแผน
| Subagent | Workflow | Agent team | |
|---|---|---|---|
| ใครถือแผน | Claude ตัดสินทีละ turn | สคริปต์ | lead ตัดสินทีละ turn ทีมคุยกันเอง |
| ผลระหว่างทางอยู่ที่ไหน | context ของ Claude | ตัวแปรในสคริปต์ | ข้อความ + task list ร่วม |
| ขนาดที่เหมาะ | ไม่กี่งานต่อครั้ง | หลักสิบถึงหลักร้อย agent | 3–5 คนที่ทำงานยาว |
| อะไรใช้ซ้ำได้ | definition ของผู้ช่วย | ตัวสคริปต์ทั้งหมด (/ชื่อ) |
definition ของสมาชิก |
| ถูกขัดจังหวะ | turn เริ่มใหม่ | ทำต่อได้ใน session เดิม | teammate ทำงานต่อ |
| สถานะ | ไม่ได้ระบุ | ไม่ได้ระบุ | experimental (ตาม docs) |
ใช้ใน claude -p / CI |
ได้ | ได้ | ไม่ได้ |
นอกจากสามวิธีนี้ยังมี skill (คำแนะนำที่ Claude ทำตามใน context ของตัวเอง ไม่ได้สร้าง agent ใหม่) และ การส่งข้อความข้าม session ระหว่าง session ที่คุณเปิดเองหลายตัว (บทที่ 14)
แถวสุดท้ายเรายืนยันเอง: เมื่อรัน
claude -pโดยเปิดCLAUDE_CODE_EXPERIMENTAL_AGENT_TEAMS=1แล้วสั่งให้สร้างทีมสองคน ได้ subagent ธรรมดา (Explore) สองตัวที่ไม่มีชื่อ ไม่ใช่ teammate แถวอื่น ๆ ในตารางตาม docs ของ Claude Code (v2.1.296) ไม่ได้ทดลองเอง ยกเว้นข้อที่ workflow ทำต่อได้ใน session เดิม ซึ่งเราลองแล้วในบทที่ 5 และข้อ task list ร่วมของ team ที่ในการทดลองบทที่ 7 ว่างเปล่าบน Opus 5.5 จนกว่าจะเปิดCLAUDE_CODE_ENABLE_TODO_TOOLS=1
สองข้อที่ควรจำก่อนอ่านต่อ
Subagent ช่วยรักษา context หลัก และทุกงานย่อยเริ่มจาก context สะอาด ผู้ช่วยแต่ละตัวทำงานใน context ของตัวเองแล้วส่งกลับแค่บทสรุป ผลคือสองอย่าง อย่างแรก session หลักไม่ต้องแบกไฟล์ที่อ่านและผลของคำสั่งทั้งหมด (ในการทดลองตรวจบั๊กด้านล่าง context หลักเหลือ 48k จาก 133k) อย่างที่สอง งานแต่ละชิ้นเริ่มจากหน้าว่าง สิ่งที่ค้างมาจากงานก่อนหน้า เช่น สมมติฐานที่ผิด ไฟล์ที่ไม่เกี่ยว หรือคำสั่งเก่า จึงไม่ปนเข้าไปในงานใหม่ ที่เรียกกันว่า context pollution (บทที่ 12 เป็นตัวอย่าง: agent ตัวเดียวที่อ่าน log ทั้งชุดมีแนวโน้มจะเห็นคำว่า "payment provider timeout" แล้วยึดสมมติฐานนั้น) ราคาของข้อนี้คือผู้ช่วยไม่เห็นบทสนทนาของคุณ ต้องเขียนข้อความมอบงานให้ครบ (บทที่ 2)
Workflow ให้ลูปและเงื่อนไขหยุดอยู่ในโค้ด ไม่ใช่ให้ LLM ตัดสินทีละ turn ใน workflow สคริปต์เป็นฝ่ายกำหนดว่าจะส่งงานให้ใคร วนอีกรอบไหม และหยุดเมื่อไหร่ เช่น วนแก้จนเทสต์ผ่าน หรือหยุดเมื่อสองรอบติดกันไม่คืบหน้า (บทที่ 6) ผลคือโครงของการทำงานคาดเดาได้และทำซ้ำได้เหมือนเดิมทุกครั้ง แม้ว่าคำตอบของ model ข้างในแต่ละ agent จะไม่เหมือนกันทุกรอบ แนวคิดนี้ไม่ใช่ของใหม่ ลูป Ralph Wiggum ของ Geoffrey Huntley ก็เป็นแบบเดียวกันในรูปที่เล็กที่สุด เขาเขียนว่าในรูปแบบบริสุทธิ์ Ralph คือ Bash loop (while :; do cat PROMPT.md | claude-code ; done) และพูดว่า "the technique is deterministically bad in an undeterministic world" (แหล่ง: ghuntley.com/ralph) ข้อควรระวัง: Ralph คือลูปภายนอกที่ป้อน prompt เดิมซ้ำ ส่วน workflow ของ Claude Code คือสคริปต์ที่ runtime รันและมีหลาย agent เราเทียบกันที่หลักการ (โค้ดถือลูป) ไม่ได้บอกว่าสองอย่างนี้เหมือนกัน
หนังสือเล่มนี้สอนตามลำดับ subagent → workflow → team เพราะเรียงจากเบาไปหนัก และปิดท้ายด้วยวิธีที่ docs ระบุว่ายังเป็น experimental
1.4 งานแบบไหน เหมาะกับวิธีไหน
ตารางนี้ดึงจากบทที่ 8–13 ทุกแถวเป็นงานที่เรารันจริง ตัวเลขอยู่ในบทนั้น ๆ
| งาน | วิธีที่ได้ผล | ผลที่ได้ | ทำไมวิธีนี้ | บท |
|---|---|---|---|---|
| ฟีเจอร์ที่แตะทุกชั้น (Wishlist) | team แบ่งตามเจ้าของไฟล์ | เทสต์ 90/90 · ไม่มีไฟล์ชน · 350 วินาที · $2.73 | frontend, backend และ qa ต้องเห็นสัญญา API ตรงกัน และ qa ที่เขียนเทสต์จากสัญญาเจอช่องโหว่ของสัญญาก่อนที่ความเข้าใจจะแยกทาง | 8 |
| รีวิว PR 14 ไฟล์ | session เดียว (ทั่วไป) · team (เสี่ยงสูง) | session เดียว $0.62 จับปัญหาที่รู้ครบ 4/4 · team ให้ 13 ข้อ การถกเถียงปรับระดับความรุนแรง | งานเล็กพอให้ model ตัวเดียวอ่านหมด ไม่ต้องจ่ายค่าส่งงาน | 9 |
| แผนหลายเฟส (PromptPay) ที่รันโดยไม่มีคนเฝ้า | workflow | เทสต์ 104/104 · ไม่มีคำขออนุญาตถึงคน · $8.81 | สคริปต์เดินตามเฟสเอง ทำต่อได้หลังถูกเพดาน 10 นาที (ทีมต้องตอบคำขออนุญาต 31 ครั้ง) | 10 |
| เอกสาร API ทั้งชุด + ตัวอย่างต้องรันจริง | workflow แบบ pipeline | ตัวอย่าง curl ผ่าน 86/86 | เขียนแล้วตรวจทีละไฟล์ มีประตูที่เครื่องรันได้ (รอบแรกไม่มีประตู ได้ 0 ตัวที่รันจริง) | 11 |
| incident ที่สัญญาณชี้หลายทาง | workflow สมมติฐานแข่งกัน · team โต้วาที | ได้สาเหตุถูกต้องทั้งสองแบบ ($5.44 / $4.70) | แบ่งตามสมมติฐานกันยึดเรื่องเดียว และต้องยืนยันด้วยการรัน benchmark หรือเทสต์จริงก่อนสรุป | 12 |
| แยกโค้ดข้าม 2 repo | subagent หนึ่งตัวต่อ repo | ทั้งสอง repo เขียว · 10 นาที · $2.62 | ไฟล์สัญญา (CHANGELOG) ทำให้อีกฝั่งไม่ต้องรู้ไส้ใน | 13 |
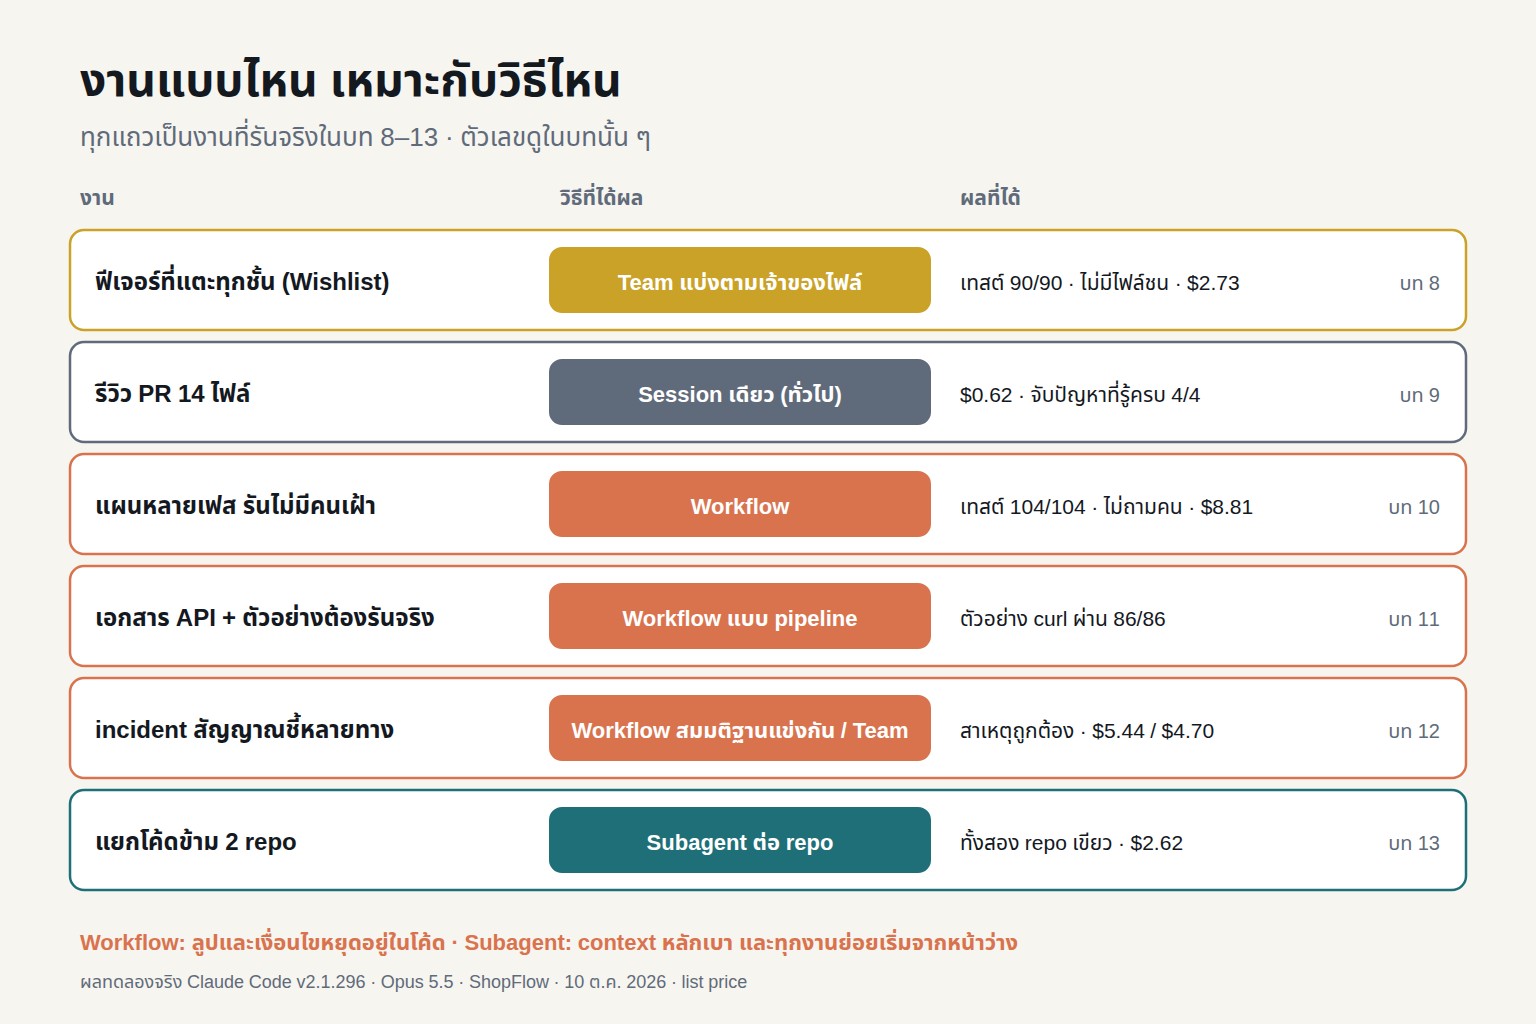
workflow ทำอะไรที่วิธีอื่นทำไม่ได้ สามอย่าง อย่างแรกคือรันโดยไม่มีคนเฝ้าจนจบ เพราะลูปและเงื่อนไขหยุดอยู่ในโค้ด (บทที่ 10) อย่างที่สองคือทำซ้ำได้เป็นคำสั่ง /ชื่อ ที่ใช้กับงานชนิดเดียวกันทุกครั้ง (บทที่ 5) และอย่างที่สามคือมีประตูคุณภาพที่เครื่องตรวจได้ เช่น รันตัวอย่างทุกข้อ ยืนยันสาเหตุด้วย benchmark หรือให้ผู้ตรวจอิสระหักล้างก่อนรายงาน (บทที่ 6, 11, 12) ถ้างานของคุณมีสามอย่างนี้อย่างใดอย่างหนึ่ง workflow คือวิธีแรกที่ควรลอง ถ้าไม่มีเลย (งานเล็ก งานเรียงลำดับ งานที่ต้องคุยกับคุณบ่อย) วิธีที่เบากว่าพอ
subagent ทำอะไรที่วิธีอื่นทำไม่ได้ คือรักษา context หลักและเริ่มทุกงานย่อยจากหน้าว่าง เหมาะกับงานข้างทางที่อ่านเยอะแต่ต้องการแค่บทสรุป เช่น การแยกโค้ดทีละ repo ในบทที่ 13
1.5 ทดลองก่อนเขียน: ตรวจบั๊กทั้ง repo สี่แบบ — แต่ละวิธีซื้ออะไร
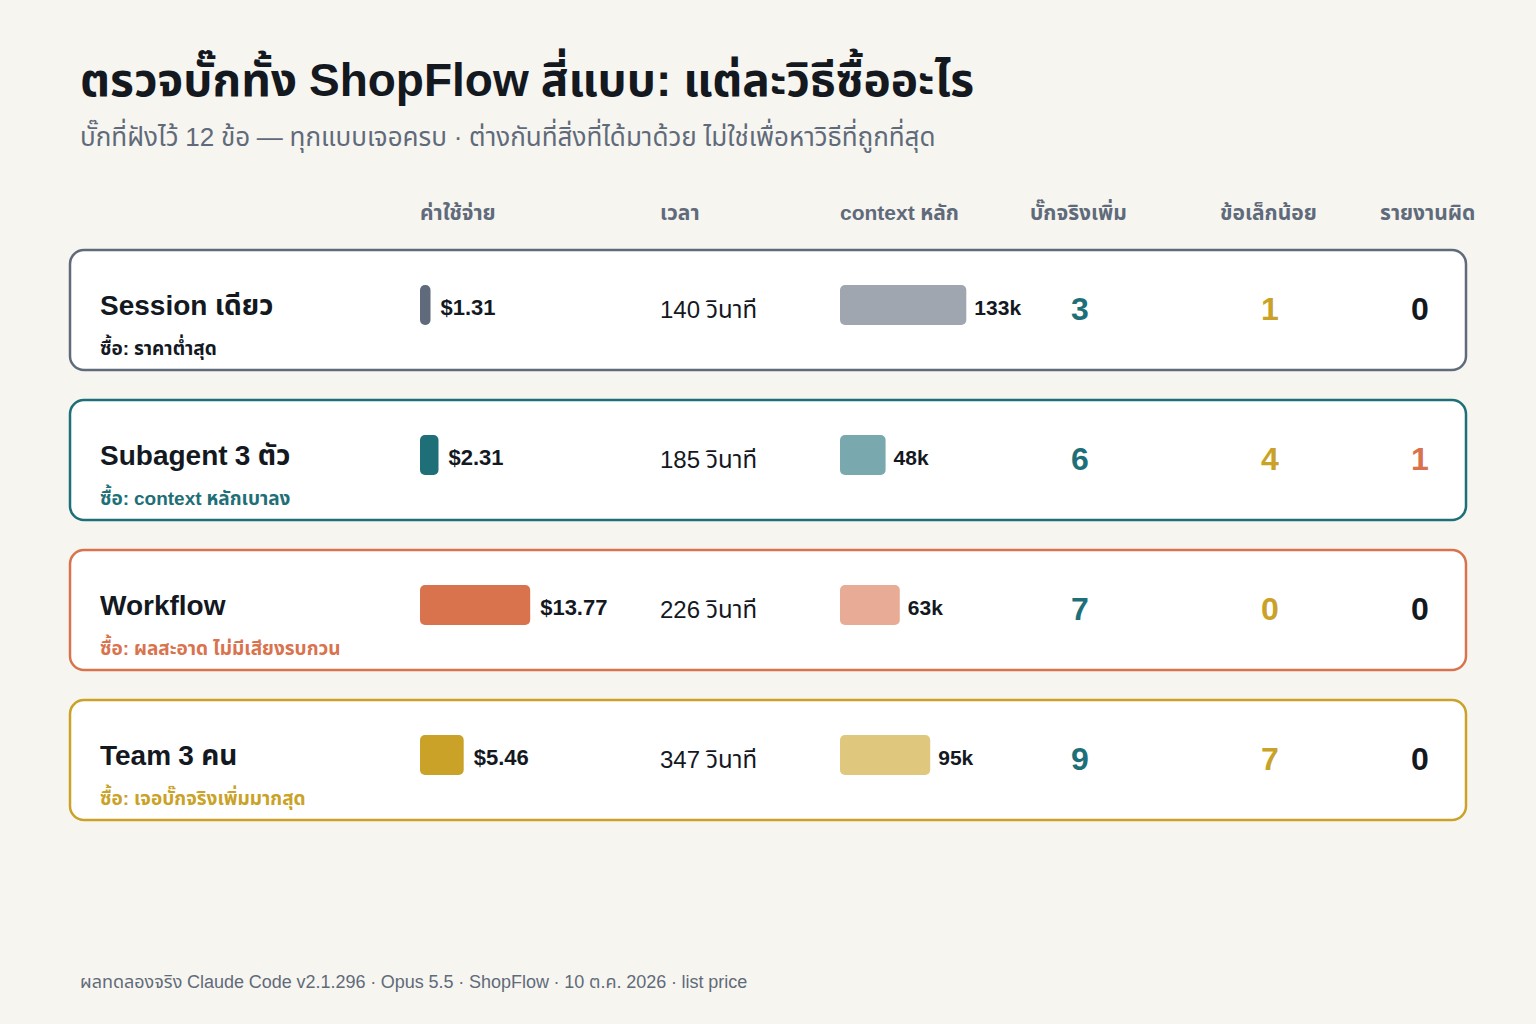
ก่อนดูงานจริงของแต่ละวิธี เราลองสิ่งที่ง่ายที่สุดก่อน: งานเดียวกัน ทำสี่แบบ งานนี้ ไม่ใช่งานที่ workflow ถนัด เพราะ repo เล็กพอที่ model ตัวเดียวอ่านจบในรอบเดียว เราใช้มันเพื่อวัดว่าแต่ละวิธีให้อะไรต่างกันในเรื่อง context ความสะอาดของผล และความครอบคลุม ไม่ใช่เพื่อหาผู้ชนะ
โจทย์
ShopFlow คือร้านค้าออนไลน์ตัวอย่างที่เราสร้างขึ้นเพื่อใช้ทั้งเล่ม (Express + SQLite + หน้าเว็บ TypeScript ราว 3,500 บรรทัด เทสต์ 58 ตัว) เราฝังบั๊กไว้ 12 ข้อที่ต่างประเภทกัน และวางโค้ดที่ดูน่าสงสัยแต่ไม่ผิดไว้อีก 3 จุดเพื่อวัดการรายงานผิด โจทย์คือ "ตรวจหาข้อบกพร่องทั้ง repo ห้ามแก้ไฟล์ สรุปเป็นรายการ JSON" ทุกแบบทำงานแบบอ่านอย่างเดียว (อ่านไฟล์ ค้นหา และรันคำสั่งที่ไม่แก้ไฟล์) และเริ่มจากสำเนาของ repo ที่เหมือนกันทุกตัว
| แบบ | prompt (ย่อ) |
|---|---|
| Session เดียว | ตรวจเอง ห้ามส่งต่อ (ปิด Agent และ Workflow) |
| Subagent | ใช้ subagent สามตัวขนานกันตามส่วนของโค้ด แล้วรวมผลและตรวจซ้ำข้อที่สงสัย |
| Workflow | ใช้ workflow: reviewer หนึ่งตัวต่อส่วน แล้วให้ skeptic อิสระตรวจหักล้างทุกข้อก่อนรายงาน |
| Team | ตั้งทีมสามคนตามส่วน แต่ละคนส่งข้อค้นพบให้อีกสองคนพยายามหักล้างหรือยืนยัน แล้ว lead รวม |
ข้อที่ไม่ตรงกับบั๊กที่ฝังไว้ ถูกส่งให้ agent ผู้ตัดสินอีกตัวที่อ่านโค้ดจริงและรันเทสต์พิสูจน์ในสำเนาแยก แล้วจัดเป็นบั๊กจริง ข้อเล็กน้อย (จริงแต่ไม่สำคัญ หรือเป็นข้อเสนอเสริมความแข็งแรง) หรือรายงานผิด
ผล
| Session เดียว | Subagent 3 ตัว | Workflow | Team 3 คน | |
|---|---|---|---|---|
| เวลา | 140 วินาที | 185 วินาที | 226 วินาที | 347 วินาที |
| ค่าใช้จ่าย | $1.31 | $2.31 | $13.77 | $5.46 |
| agent | 0 | 3 | 96 | 3 |
| context สูงสุดของ session หลัก | 133k | 48k | 63k | 95k |
| บั๊กที่ฝังไว้ที่เจอ | 12/12 | 12/12 | 12/12 | 12/12 |
| บั๊กจริงเพิ่มเติม | 3 | 6 | 7 | 9 |
| ข้อเล็กน้อย | 1 | 4 | 0 | 7 |
| รายงานผิด | 0 | 1 | 0 | 0 |
| คำขออนุญาตที่ต้องตอบระหว่างทาง | 0 | 0 | 0 | 12 |
อ่านผลอย่างไร
- บน repo ขนาดนี้ session เดียวพอสำหรับบั๊กหลัก Opus 5.5 อ่านโค้ด 3,500 บรรทัดในรอบเดียวแล้วเจอบั๊กที่ฝังไว้ครบ การแบ่งงานจึงไม่ได้ซื้อ "การเจอ" แต่ซื้ออย่างอื่น (ข้อ 2–4) ถ้างานของคุณคือหาบั๊กสำคัญใน repo ขนาดกลางครั้งเดียว ไม่ต้องใช้หลาย agent
- subagent ซื้อพื้นที่ของ session หลัก context หลักเหลือ 48k แทน 133k แลกกับราคาเพิ่ม 76% คุ้มเมื่อการตรวจเป็นแค่ขั้นแรกของงานยาว
- workflow ซื้อความสะอาดของผล ขั้นตรวจหักล้างตัดข้อเล็กน้อยออกหมด ไม่มีรายงานผิด ราคาที่เห็นมาจากการตรวจหักล้างต่อข้อค้นพบ (96 agent) ถ้าไม่ใส่ขั้นนั้นเหลือ 6 agent $2.50 (บทที่ 6) จุดที่ workflow ได้เปรียบจริงคือเมื่อผลต้องผ่านประตูที่เครื่องตรวจได้ หรือรันซ้ำทุกสัปดาห์ ซึ่งงานครั้งเดียวชิ้นนี้ไม่ได้ทดสอบ (บทที่ 10–12)
- team ซื้อความครอบคลุมข้ามส่วน teammate ส่งข้อค้นพบข้ามส่วนกัน จึงเจอบั๊กจริงที่ไม่ได้ฝังไว้มากที่สุด เช่น checkout แบบ PromptPay ที่ล้มเหลวทุกครั้งเพราะหน้าเว็บไม่ส่ง token ที่ backend ต้องการ แต่ก็มีข้อเล็กน้อยปนมามากที่สุด และมีคำขออนุญาตเด้งมาให้ตอบ 12 ครั้ง
- ไม่มีแบบไหนชนะทุกด้าน แต่ละแบบซื้อสิ่งต่างกัน และคุณจ่ายสำหรับสิ่งที่ไม่ต้องการได้ง่ายมาก
1.6 Decision tree
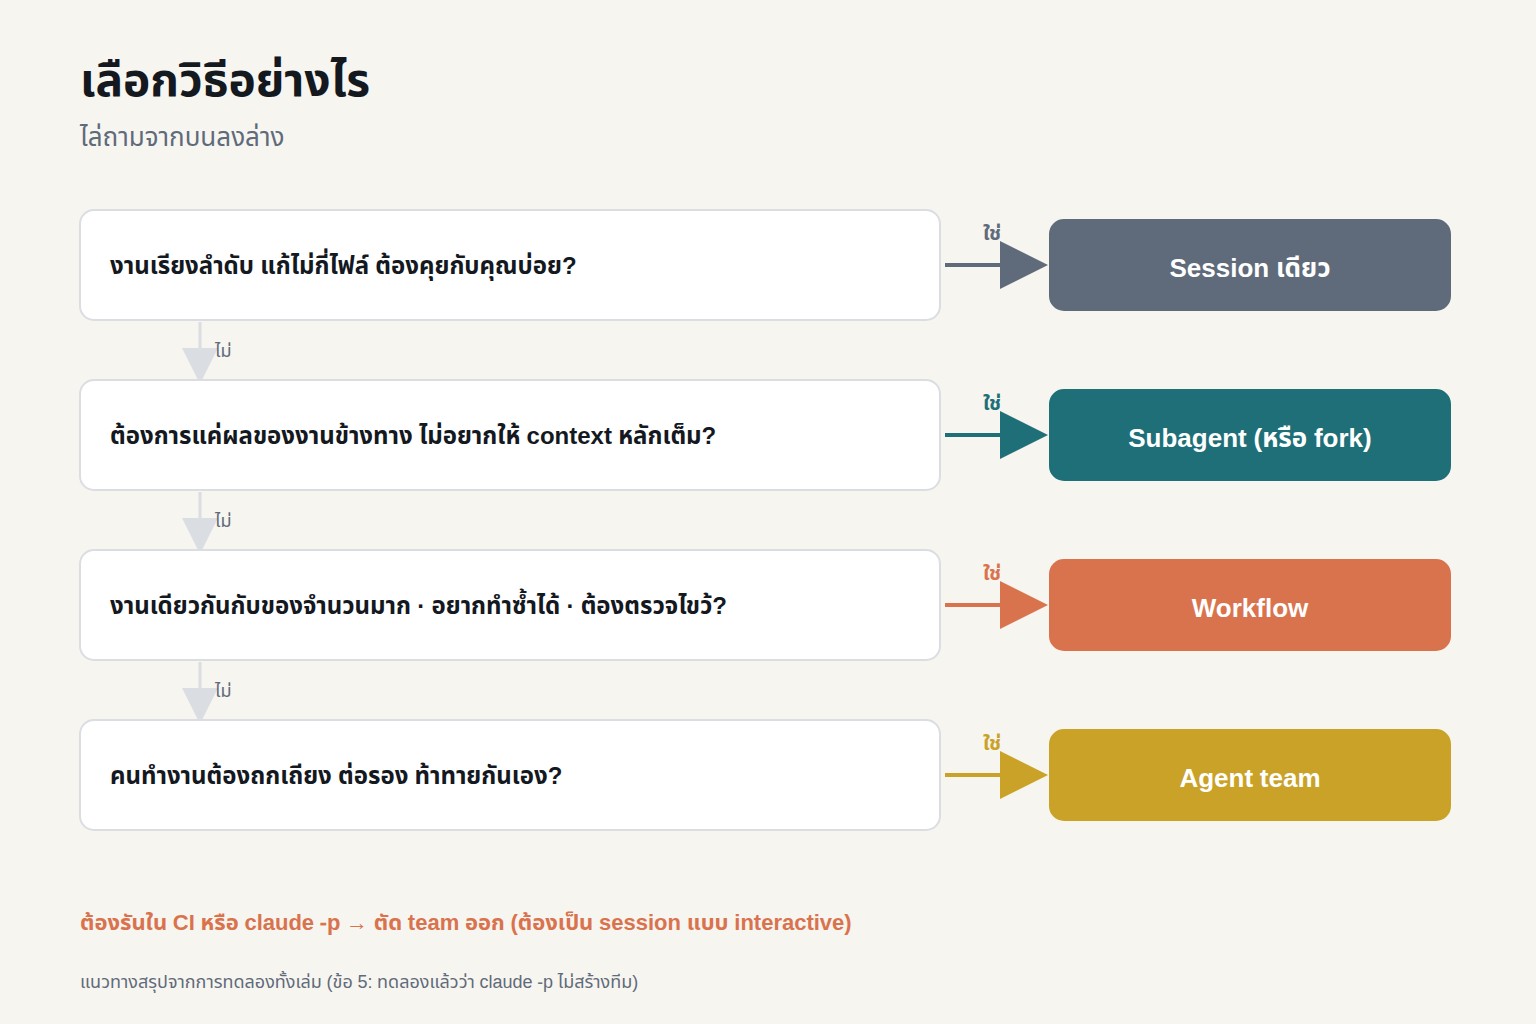
ไล่ถามจากบนลงล่าง
- งานเรียงลำดับ แก้ไฟล์เดียวหรือไม่กี่ไฟล์ ต้องคุยกับคุณบ่อย? → session เดียว
- ต้องการแค่ผลลัพธ์ของงานข้างทาง และไม่อยากให้ context หลักเต็ม? → subagent (หรือ fork ถ้างานต้องใช้บริบทที่คุยกันมาแล้ว)
- งานเดียวกันกับของจำนวนมาก, อยากให้ทำซ้ำได้แบบเดิม, หรือต้องตรวจไขว้ก่อนเชื่อ? → workflow
- คนทำงานต้องถกเถียง ต่อรอง ท้าทายสมมติฐานของกันเอง? → agent team
- ต้องรันใน CI หรือ
claude -p? → ตัด team ออก (ต้องเป็น session แบบ interactive ในการทดลองของเราclaude -pไม่สร้างทีมให้)
ถ้าลังเลระหว่างสองวิธี ให้เลือกวิธีที่เบากว่าก่อน แล้วค่อยขยับขึ้นเมื่อเห็นว่าไม่พอ
1.7 เมื่อไหร่ไม่ควรใช้ multi-agent
งานเล็กหรืองานที่ output สั้น ในบทที่ 4 การส่งชุดเทสต์ที่ผ่านหมดให้ subagent รันแพงขึ้นราว 73% โดย context หลักไม่ลดลงเลย ทุกการส่งงานมีค่าเขียนข้อความมอบงาน ค่า system prompt ของ agent ใหม่ และค่าสรุปผล
งานที่ขนานไม่ได้ ถ้าขั้น B ต้องใช้ผลของ A และ C ต้องใช้ผลของ B การแบ่งให้สามคนทำแค่เพิ่มการส่งต่อ ในบทที่ 6 workflow ที่ย้ายไฟล์พร้อมกันพังตรงสองไฟล์ที่พึ่งพากัน
งานที่แก้ไฟล์เดียวกัน agent สองตัวแก้ไฟล์เดียวกันคือการเขียนทับกัน ถ้าแบ่งเจ้าของไฟล์ไม่ได้ อย่าแบ่งงาน
งานที่ต้องการคุณตัดสินระหว่างทาง workflow ถามคุณกลางทางไม่ได้ ทีมที่รอคำอนุญาตจากคุณจะค้าง (ในบทที่ 5 workflow รอคำอนุญาตที่ถูกหน้าจอบังไว้เกือบสิบนาที)
เมื่อ model ตัวเดียวอ่านทั้งงานได้อยู่แล้ว model ปัจจุบันมี context ใหญ่และอ่านโค้ดหลายพันบรรทัดได้ในรอบเดียว การแบ่งงานเพื่อ "ช่วยให้มันอ่านไหว" จำเป็นน้อยลง ในการทดลองข้างต้น session เดียวอ่านทั้ง repo ได้ในรอบเดียว เหตุผลที่ยังเหลือคือการรักษาพื้นที่ของ session หลัก การทำงานขนาน การตรวจไขว้ และการทำซ้ำได้
| ถ้าคุณต้องการ... | วิธีที่ให้ | ตัวอย่างในเล่ม | ราคาในการทดลองตรวจบั๊ก (เทียบกับ session เดียว) |
|---|---|---|---|
| ผลดีพอ ราคาถูก | session เดียว | รีวิว PR $0.62 (บท 9) | 1× |
| session หลักเบา ทำงานต่อได้นาน เริ่มงานย่อยจากหน้าว่าง | subagent | แยก 2 repo $2.62 (บท 13) | ~1.8× |
| รันเองไม่มีคนเฝ้า · ทำซ้ำได้ · ผลผ่านประตูตรวจ | workflow | แผนหลายเฟส $8.81 (บท 10) · docs 86/86 (บท 11) | ~10× (ตรวจหักล้างต่อข้อค้นพบ 96 agent) |
| มุมมองที่ท้าทายกัน ครอบคลุมข้ามส่วน | team | Wishlist 90/90 (บท 8) | ~4× |
เล่มนี้จัดอย่างไร
- ภาค 1 (บทที่ 1–3) ภาพรวม การแบ่งงานตาม context และ agent definition ที่ใช้ได้ทั้งสามวิธี
- ภาค 2 (บทที่ 4–7) วิธีหลักทีละวิธี: subagent, workflow, workflow patterns, agent team
- ภาค 3 (บทที่ 8–13) case study บน ShopFlow ทุกบทรันจริง เลือกวิธีพร้อมเหตุผล มีตัวเลขจริงและหัวข้อ "พังตรงไหน"
- ภาค 4 (บทที่ 14–16) ข้าม session ข้ามเครื่อง โมเดลในเครื่อง และความปลอดภัย
- ภาค 5 (บทที่ 17–18) playbook ที่ใช้ทุกวัน และตัวเลขรวมทั้งเล่ม
- ภาคผนวก definition, สคริปต์ workflow, prompt, ข้อมูลตามเวอร์ชัน, kit, tmux และสิ่งที่เปลี่ยนจาก Edition 1
สรุปบท
- session เดียวมีข้อจำกัดสามข้อ: context เต็ม, compaction ทิ้งของสำคัญ, ทำได้ทีละอย่าง
- สามวิธีต่างกันที่ ใครถือแผน: Claude ทีละ turn (subagent), สคริปต์ (workflow), lead ที่คุมทีมซึ่งคุยกันเอง (team)
- เลือกวิธีตามสิ่งที่งานต้องการ: context หลักเบาและงานย่อยเริ่มจากหน้าว่าง (subagent) · ลูปและเงื่อนไขหยุดอยู่ในโค้ด รันเองไม่มีคนเฝ้า ทำซ้ำได้ และมีประตูตรวจที่เครื่องรันได้ (workflow: บท 10, 11, 12) · คนในทีมที่ท้าทายและต่อรองกัน (team: บท 8, 9, 12) · หรือไม่ต้องใช้อะไรเลยนอกจาก session เดียว (บท 9)
- ในการทดลองตรวจบั๊กทุกแบบเจอบั๊กที่ฝังไว้ครบ 12 ข้อ ต่างกันที่สิ่งที่ได้มาด้วย: subagent ลด context หลักได้ 64% workflow ไม่มีเสียงรบกวนเลย team เจอบั๊กจริงเพิ่มมากที่สุด และ session เดียวทำได้ในราคาต่ำสุด ($1.31) งานตรวจครั้งเดียวบน repo เล็กจึงไม่ใช่งานที่ต้องใช้หลาย agent
- เลือกวิธีที่เบาที่สุดที่ทำงานได้ แล้วค่อยขยับขึ้น
- อย่าใช้หลาย agent กับงานเล็ก งานที่ต้องเรียงลำดับ งานที่แก้ไฟล์เดียวกัน หรืองานที่ต้องการให้คุณตัดสินระหว่างทาง