บทที่ 1: LLM คืออะไร
ลองนึกภาพว่าคุณเปิดแอปแชตขึ้นมา พิมพ์ว่า "ช่วยอธิบายว่าทำไมท้องฟ้าถึงเป็นสีฟ้า ให้เด็กประถมเข้าใจ" แล้วกดส่ง ภายในไม่กี่วินาที ข้อความโต้ตอบก็ปรากฏขึ้น — อธิบายอย่างเป็นขั้นตอน ใช้ภาษาเรียบง่าย มีตัวอย่างประกอบ พร้อมทั้งแนะนำให้ทดลองง่าย ๆ ที่บ้าน คุณอาจคิดว่านี่คือ "AI ที่คิดได้เหมือนมนุษย์" แต่ความจริงแล้ว เบื้องหลังข้อความนั้นคือตัวเลขนับพันล้านตัวที่ถูกคูณและบวกกันในเสี้ยววินาที โดยปราศจาก "ความคิด" หรือ "จิตสำนึก" ใด ๆ ทั้งสิ้น หนังสือเล่มนี้จะพาคุณเปิดฝาดูกลไกภายในของ Large Language Model หรือ LLM — ตั้งแต่ตอนที่คุณพิมพ์ข้อความ ไปจนถึงตอนที่โมเดลตอบกลับมาทีละคำ — เพื่อให้คุณเข้าใจว่ามันทำงานได้อย่างไรจริง ๆ
1.1 เกริ่นนำ: AI สนทนาได้ยังไง — จาก ELIZA สู่ ChatGPT
ก่อนจะเข้าใจ LLM เราควรมองย้อนกลับไปดูว่าเรามาถึงจุดที่ AI "พูดคุย" กับมนุษย์ได้อย่างไร
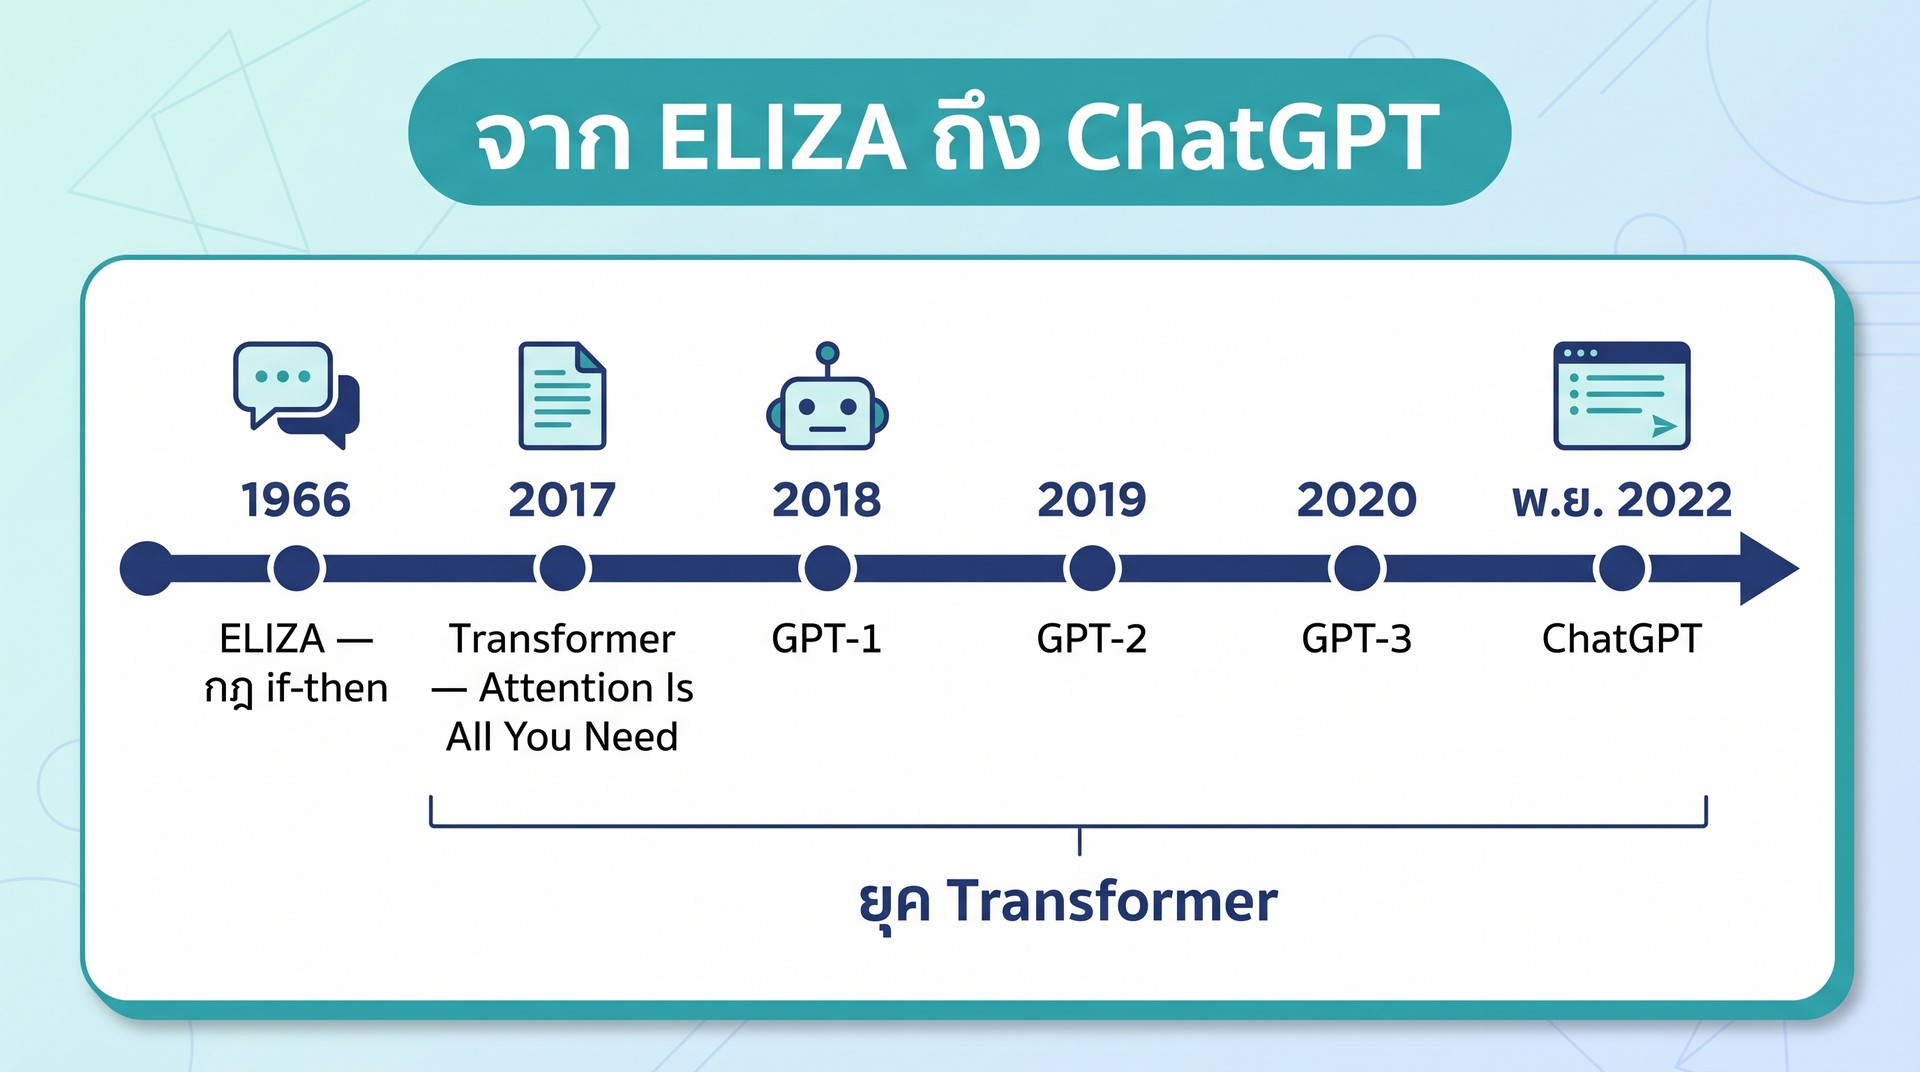
ย้อนกลับไปปี 1966 — ยุคที่คอมพิวเตอร์ยังใหญ่เท่าห้องและทำงานได้น้อยกว่าโทรศัพท์ในกระเป๋าคุณทุกวันนี้ — Joseph Weizenbaum นักวิทยาศาสตร์คอมพิวเตอร์ที่ MIT ได้สร้างโปรแกรมชื่อ ELIZA ขึ้นมา ELIZA ถูกออกแบบให้เลียนแบบนักจิตบำบัด โดยใช้เทคนิคง่าย ๆ อย่างการจับคำสำคัญแล้วโยนกลับเป็นคำถาม
คุณพิมพ์: "ฉันรู้สึกเศร้า" ELIZA ตอบ: "ทำไมคุณถึงรู้สึกเศร้าล่ะ"
คุณพิมพ์: "แม่ของฉันทำให้ฉันเสียใจ" ELIZA ตอบ: "เล่าให้ฉันฟังเพิ่มเกี่ยวกับแม่ของคุณหน่อย"
ELIZA ไม่ได้ "เข้าใจ" อะไรเลย — มันแค่ใช้กฎ if-then ง่าย ๆ จับคำสำคัญ แต่ผู้ใช้หลายคนกลับรู้สึกว่า ELIZA เข้าใจพวกเขาจริง ๆ ปรากฏการณ์นี้เรียกว่า ELIZA Effect — มนุษย์เรามักจะอ่าน "ความเข้าใจ" ลงไปในระบบที่เลียนแบบภาษาได้ แม้ว่าระบบนั้นจะไม่มีวันเข้าใจจริงก็ตาม
นับจาก ELIZA เป็นต้นมา AI พัฒนาผ่านหลายยุค: ระบบ rule-based ที่เขียนกฎด้วยมือ → machine learning ที่เรียนจากข้อมูล → deep learning ที่ใช้ neural network หลายชั้น จนมาถึงปี 2017 เมื่อนักวิจัยที่ Google ตีพิมพ์ paper ชื่อ "Attention Is All You Need" — นี่คือจุดกำเนิดของสถาปัตยกรรม Transformer ซึ่งเป็นรากฐานของ LLM ทุกตัวที่เราใช้กันในปัจจุบัน
จาก Transformer นำไปสู่ GPT-1 (2018), GPT-2 (2019), GPT-3 (2020) และ ChatGPT (พฤศจิกายน 2022) — โมเดลที่ทำให้คนทั่วโลกตระหนักว่า AI สามารถ "สนทนา" ได้อย่างน่าทึ่ง ChatGPT มีผู้ใช้ราว 100 ล้านคนต่อเดือนภายในประมาณ 2 เดือนหลังเปิดตัว — เป็นประมาณการของนักวิเคราะห์ UBS ที่ Reuters รายงานในเดือนกุมภาพันธ์ 2023 (ไม่ใช่ตัวเลขทางการของ OpenAI) และรายงานเดียวกันระบุว่า TikTok ใช้เวลาราว 9 เดือนกว่าจะถึงระดับเดียวกัน
เคล็ดลับ: ตลอดหนังสือเล่มนี้ เมื่อเราใช้คำว่า "LLM" เราหมายถึงโมเดลภาษาใหญ่ในตระกูล Decoder-Only Transformer — ซึ่งรวมถึง GPT, Claude, Gemini, Llama, Qwen, DeepSeek และ Gemma โมเดลเหล่านี้แม้จะต่างยี่ห้อ แต่ใช้หลักการพื้นฐานเดียวกัน ส่วนรายละเอียดภายในที่ต่างกัน (เช่น attention แบบ hybrid หรือ MoE) เราจะแยกให้ดูในบทที่ 5, 6 และ 21 ข้อควรรู้: โมเดลปิดอย่าง GPT, Claude และ Gemini ไม่เปิดเผยสถาปัตยกรรมหรือขนาดอย่างเป็นทางการ สิ่งที่เรารู้จริงมาจากโมเดล open-weight ที่เปิดน้ำหนักและ config ให้ตรวจเอง
1.2 นิยาม LLM: Large Language Model
LLM ย่อมาจาก Large Language Model — แปลตรงตัวว่า "โมเดลภาษาขนาดใหญ่" แต่นิยามนี้ยังไม่ช่วยให้เข้าใจ ลองแยกทีละคำ:
Language Model (โมเดลภาษา): คือระบบที่ถูกเทรนให้ "ทำนายคำถัดไป" จากข้อความที่เห็นก่อนหน้า ตัวอย่างเช่น ถ้าเห็นคำว่า "แมวกิน..." โมเดลอาจทำนายว่าคำถัดไปน่าจะเป็น "ปลา" (มากกว่า "รถ" หรือ "ฟ้า")
Large (ใหญ่): โมเดลเหล่านี้มี parameters (พารามิเตอร์ — ตัวเลขที่เก็บ "ความรู้") จำนวนมหาศาล ตั้งแต่ระดับ 1,000,000,000 (หนึ่งพันล้าน) ไปจนถึงมากกว่า 1,000,000,000,000 (หนึ่งล้านล้าน) ตัว ยิ่งมี parameters มาก โมเดลก็ยิ่งสามารถเก็บรูปแบบภาษาและความรู้ที่ซับซ้อนได้มากขึ้น
เมื่อรวมกัน: LLM คือ neural network ขนาดใหญ่ที่ถูกเทรนบนข้อความปริมาณมหาศาล ให้ทำนายคำถัดไปได้อย่างแม่นยำ
เบื้องหลังความสามารถในการแต่งกลอน เขียนโค้ด แปลภาษา ตอบคำถาม และให้คำปรึกษา — ทั้งหมดมาจากการทำงานพื้นฐานเดียว: ทายคำถัดไป
หมายเหตุ: คำว่า "neural network" ในที่นี้หมายถึงโครงสร้างทางคณิตศาสตร์ที่ได้แรงบันดาลใจมาจากเซลล์ประสาทในสมอง — แต่สำคัญมากที่ต้องเข้าใจว่า LLM ไม่ใช่สมอง มันไม่ "คิด" ไม่ "รู้สึก" และไม่มีจิตสำนึก มันคือระบบคณิตศาสตร์ล้วน ๆ ที่เก่งเรื่องการทำนาย pattern ในภาษา
1.3 สององค์ประกอบของ LLM: Architecture กับ Weights
LLM ทุกตัวประกอบด้วยสองส่วนที่แยกออกจากกันอย่างชัดเจน: Architecture และ Weights การเข้าใจความแตกต่างนี้เป็นพื้นฐานที่สำคัญที่สุดของหนังสือทั้งเล่ม
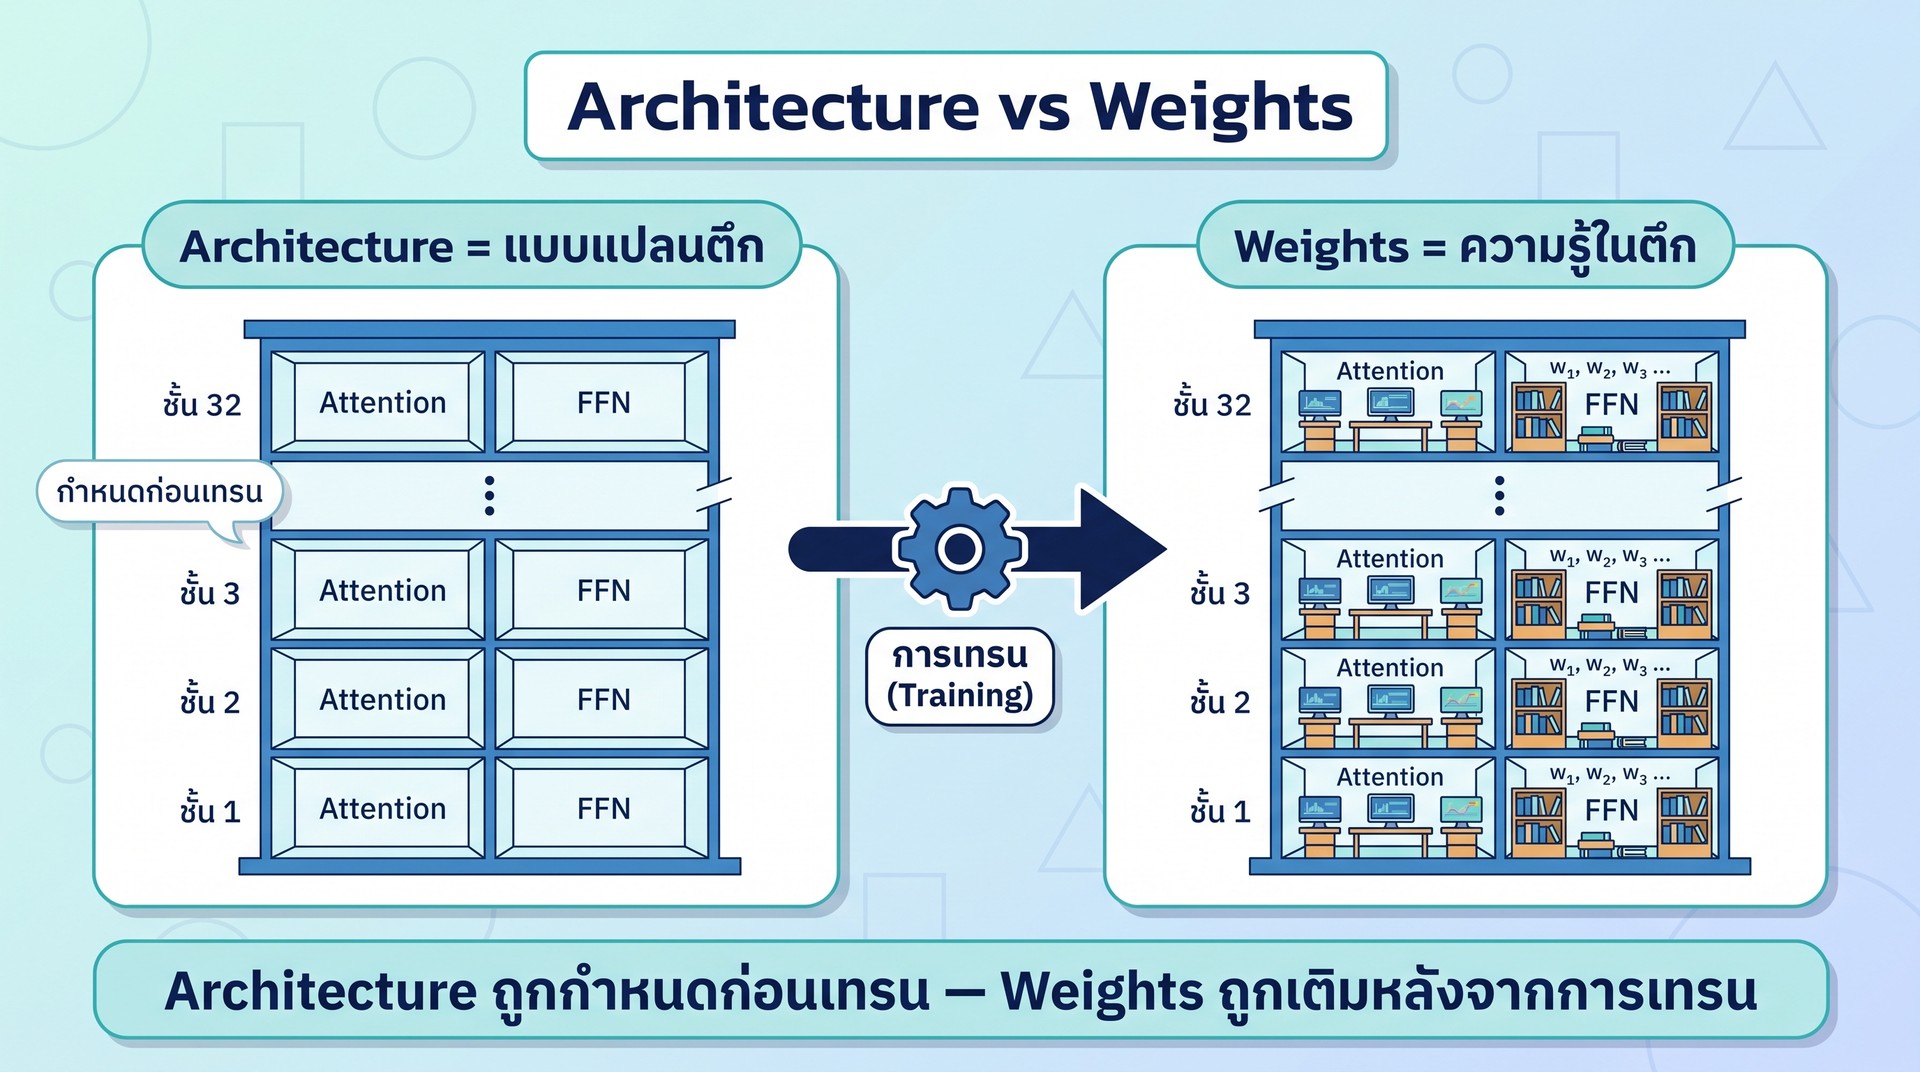
Architecture = แบบแปลนตึก
Architecture คือโครงสร้างของโมเดล — กำหนดว่ามีกี่ชั้น (layers) แต่ละชั้นมีกี่ neuron มี attention head กี่อัน มีการเชื่อมต่อกันอย่างไร Architecture ถูกกำหนดโดยมนุษย์ (วิศวกร) ก่อนที่การเทรนจะเริ่มขึ้น
เปรียบเทียบง่าย ๆ: Architecture ก็เหมือนแบบแปลนตึก — บอกว่าตึกมีกี่ชั้น แต่ละชั้นมีกี่ห้อง ห้องแต่ละประเภทเชื่อมถึงกันอย่างไร Architecture กำหนด "รูปร่าง" และ "ความสามารถทางโครงสร้าง" ของโมเดล แต่ไม่ได้บรรจุ "ความรู้" ใด ๆ
Weights = เฟอร์นิเจอร์ในตึก
Weights คือตัวเลขทั้งหมดในโมเดล — เป็นตัวแทนของ "ความรู้" ที่โมเดลเรียนรู้มาจากข้อมูลระหว่างการเทรน Weights เป็นผลลัพธ์ของการเทรน ไม่ใช่สิ่งที่มนุษย์กำหนดโดยตรง
ถ้า Architecture คือแบบแปลนตึก, Weights ก็คือเฟอร์นิเจอร์และของใช้ในตึก — หนังสือในห้องสมุด, อุปกรณ์ในห้องครัว, ข้อมูลในคอมพิวเตอร์ เราจัดของเข้าตึกทีหลัง หลังจากที่ตึกถูกสร้างตามแบบแปลนเสร็จแล้ว
เปรียบเทียบ: สมองกับความทรงจำ
อีกมุมหนึ่ง: Architecture เปรียบได้กับโครงสร้างทางกายภาพของสมอง — จำนวนเซลล์ประสาท, การเชื่อมต่อระหว่างสมองส่วนต่าง ๆ — ซึ่งถูกกำหนดโดยพันธุกรรมตั้งแต่เกิด ในขณะที่ Weights คือความทรงจำและความรู้ที่สมองสะสมมาจากประสบการณ์ชีวิต
สิ่งที่สำคัญคือ: Architecture กำหนดความสามารถสูงสุด, Weights กำหนดว่าความสามารถนั้นถูกเติมเต็มแค่ไหน ตึก 100 ชั้นที่ว่างเปล่า กับตึก 100 ชั้นที่มีห้องสมุด, ห้องทดลอง, และห้องประชุม — เป็นตึกเดียวกัน แต่ให้ประโยชน์ต่างกันโดยสิ้นเชิง
1.4 Parameters คืออะไร
คำว่า Parameters เป็นคำที่คุณจะได้ยินบ่อยที่สุดเวลาคนพูดถึง LLM — "Llama-3.1-8B คือโมเดลที่มี 8 พันล้าน parameters" หรือ "DeepSeek-V4-Pro มี 1.6 ล้านล้าน parameters" แล้ว parameter คืออะไรกันแน่?
1 parameter = 1 ตัวเลขใน weight matrix
เมื่อเราบอกว่าโมเดลมี 7B parameters (7 พันล้าน) นั่นหมายความว่ามันมีตัวเลข 7,000,000,000 ตัวที่เก็บอยู่ใน matrices (ตารางตัวเลข) ต่าง ๆ ในโมเดล ตัวเลขเหล่านี้คือ "weights" ที่เราเพิ่งพูดถึงในหัวข้อที่แล้ว
ขนาดไฟล์จริง
ตัวเลขเหล่านี้ถูกเก็บในหน่วยความจำของคอมพิวเตอร์ในรูปแบบต่าง ๆ ขึ้นอยู่กับความละเอียด (precision):
- FP32 (32 บิตต่อตัวเลข): 1 parameter = 4 bytes → 7B params ≈ 28 GB
- FP16 / BF16 (16 บิตต่อตัวเลข): 1 parameter = 2 bytes → 7B params ≈ 14 GB (นี่คือความละเอียดที่โมเดลส่วนใหญ่แจกจ่าย)
- INT8 / FP8 (8 บิต): 1 parameter = 1 byte → 7B params ≈ 7 GB
- INT4 (4 บิตต่อตัวเลข, ผ่าน quantization): 1 parameter = 0.5 bytes → 7B params ≈ 3.5 GB
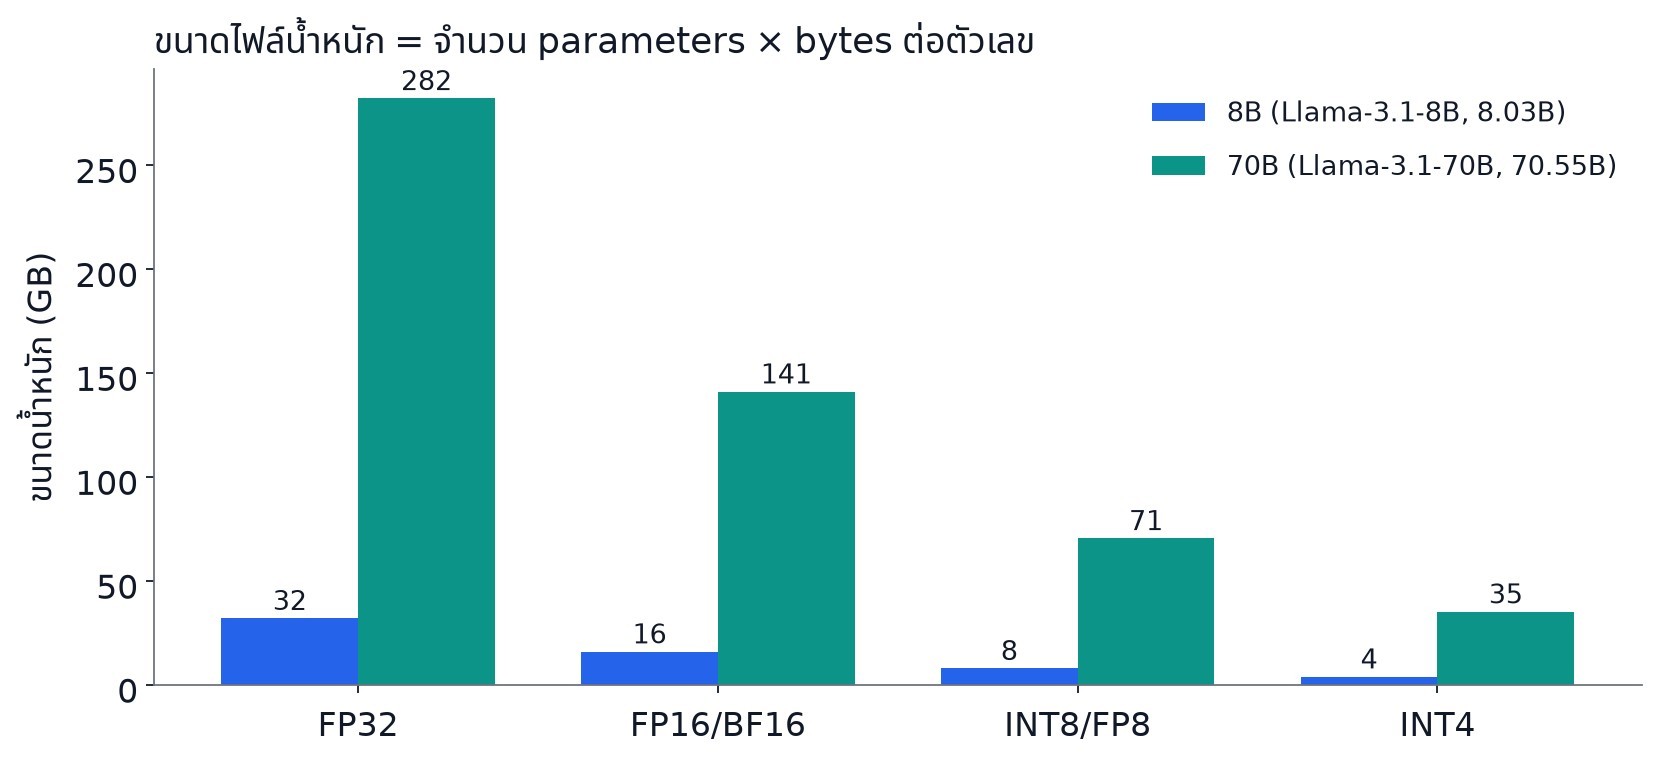
นี่คือเหตุผลที่โมเดลใหญ่ต้องใช้ GPU ที่มี VRAM มาก — weights ต้องถูกโหลดเข้า GPU memory ทั้งหมดก่อนจึงจะทำงานได้ (เราจะพูดถึง quantization ในบทที่ 19 ซึ่งเป็นเทคนิคบีบอัด weights ให้เล็กลง) ในหนังสือเล่มนี้ 1 GB = 1,000,000,000 bytes
ตัวอย่างขนาดจริง (ณ 2026-10-11)
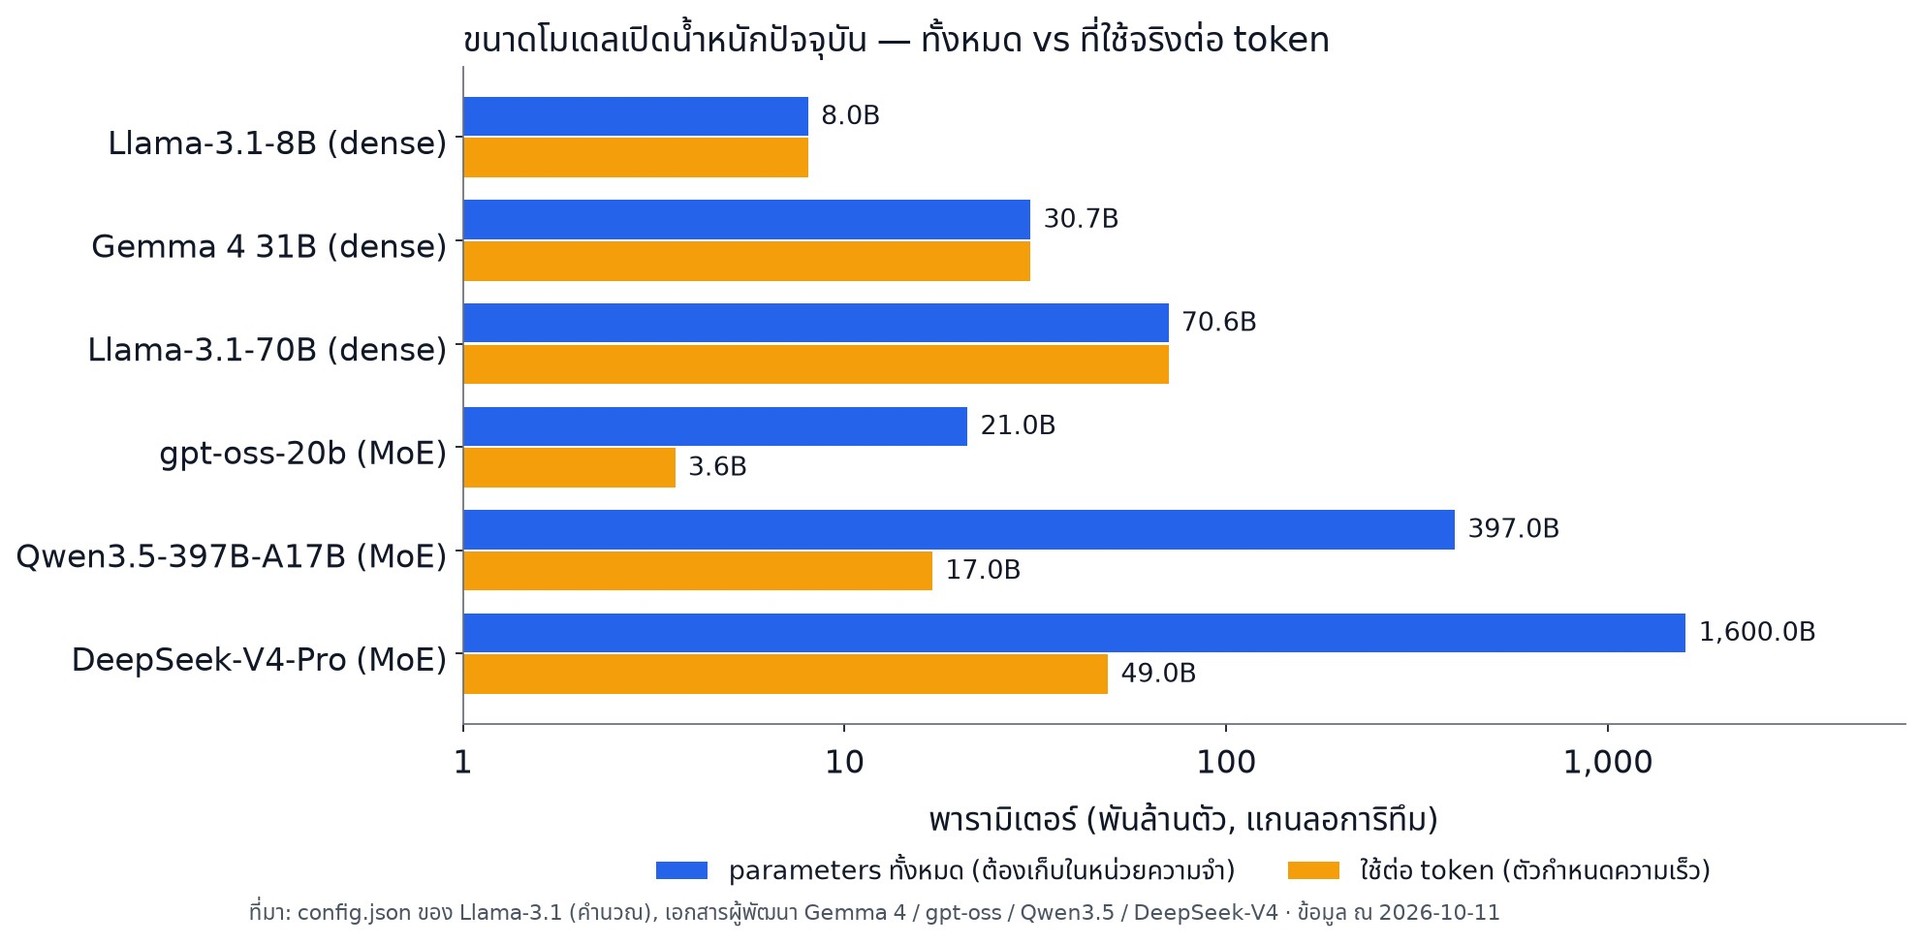
| โมเดล | Parameters ทั้งหมด | ใช้ต่อ token | น้ำหนักที่ 16 บิต |
|---|---|---|---|
| Llama-3.1-8B | 8.03 พันล้าน | 8.03 พันล้าน (dense) | ~16 GB |
| Llama-3.1-70B | 70.6 พันล้าน | 70.6 พันล้าน (dense) | ~141 GB |
| Gemma 4 31B | 30.7 พันล้าน | 30.7 พันล้าน (dense) | ~61 GB |
| gpt-oss-20b | 21 พันล้าน | 3.6 พันล้าน (MoE) | ~42 GB (แต่แจกมาแบบ MXFP4 รันใน 16 GB) |
| Qwen3.5-397B-A17B | 397 พันล้าน | 17 พันล้าน (MoE) | ~794 GB |
| DeepSeek-V4-Pro | 1.6 ล้านล้าน | 49 พันล้าน (MoE) | ~3.2 TB (แจกมาแบบ FP4 + FP8 ผสม) |
| GPT-4 | ไม่เปิดเผย (ข่าวลือ ~1.76 ล้านล้าน) | ไม่เปิดเผย | — |
สองคอลัมน์กลางคือกุญแจ: โมเดล MoE (Mixture of Experts) เก็บ parameters ทั้งหมดไว้ในหน่วยความจำ แต่ใช้เพียงบางส่วนต่อ token — ความจำต้องพอสำหรับ "ทั้งหมด" ส่วนความเร็วขึ้นกับ "ที่ใช้จริง" (เราจะเจาะลึกในบทที่ 21) ตัวเลข Llama คำนวณจาก config.json จริงของโมเดล ส่วนตัวเลขของ Gemma, gpt-oss, Qwen และ DeepSeek มาจากเอกสารของผู้พัฒนาเอง
ข้อควรระวัง — GPT-4 "1.7 ล้านล้าน": ตัวเลขนี้ไม่ใช่ข้อเท็จจริง OpenAI ไม่เคยเปิดเผยขนาดของ GPT-4 (รายงานทางเทคนิคระบุว่าไม่เปิดเผยสถาปัตยกรรม "รวมถึงขนาดโมเดล") ตัวเลข ~1.76 ล้านล้านมาจากคำพูดของ George Hotz ในพอดแคสต์เมื่อมิถุนายน 2023 (8 × 220B แบบ MoE) และรายงานของ SemiAnalysis ที่ให้ ~1.8 ล้านล้าน ทั้งสองเป็นข่าวลือที่ OpenAI ไม่เคยยืนยัน เมื่อเห็นตัวเลขขนาดของโมเดลปิด ให้ถามเสมอว่าใครเป็นคนบอก
ข้อควรระวัง: ตัวเลข VRAM จริงที่ต้องใช้มักจะสูงกว่าขนาด weights เพราะยังต้องเผื่อพื้นที่สำหรับ KV cache (บทที่ 10), activations, และ optimizer states (ถ้าเทรน) — แต่สำหรับ inference (การใช้งานปกติ) ขนาด weights คือปัจจัยหลัก
1.5 ขนาดโมเดล — เรากำหนดก่อน Training เริ่ม
มีความเข้าใจผิดที่พบบ่อยมากเกี่ยวกับ LLM: หลายคนคิดว่า "การเทรนทำให้โมเดลมี 7B parameters" — ฟังดูสมเหตุสมผล แต่ไม่ใช่ความจริง
ความจริง: ขนาดถูกกำหนดก่อน training เริ่ม
วิศวกรเป็นผู้กำหนดขนาดของโมเดลใน config file ก่อนที่การเทรนจะเริ่มขึ้นแม้แต่ step เดียว นี่คือค่าจริงใน config.json ของ Llama-3.1-8B:
hidden_size         = 4096     → มิติของเวกเตอร์ภายในแต่ละ layer
num_hidden_layers   = 32       → จำนวน transformer layers
num_attention_heads = 32       → จำนวน attention heads (มี key/value heads 8 ชุด — บทที่ 6)
intermediate_size   = 14336    → ความกว้างของ FFN
vocab_size          = 128256   → จำนวน tokens ใน vocabulary
จากตัวเลขเหล่านี้ เราคำนวณจำนวน parameters ได้โดยที่ยังไม่ต้องเทรนเลย:
attention ต่อชั้น  =  4096×4096 (Wq) + 2×4096×1024 (Wk, Wv) + 4096×4096 (Wo)  ≈  41.9 ล้าน
FFN ต่อชั้น        =  3 × 4096 × 14336                                        ≈ 176.2 ล้าน
รวม 32 ชั้น        ≈  32 × 218.1 ล้าน                                         ≈   6.98 พันล้าน
embedding 2 ตาราง  =  2 × 128256 × 4096  (ขาเข้า + ขาออก)                      ≈   1.05 พันล้าน
                                                                      รวม  ≈   8.03 พันล้าน
(ถ้าไม่เข้าใจว่า Wq, Wk, Wv, FFN คืออะไร ไม่ต้องกังวล — เราจะเปิดทีละชิ้นในบทที่ 6 และ 7 จุดที่ต้องจำตอนนี้คือ "คำนวณจากแบบแปลนได้ ก่อนเทรน")
Training ไม่ได้สร้าง parameters ใหม่ — มันแค่ "เติมตัวเลข" ลงใน parameters ที่มีอยู่แล้ว
Analogy: ตึกกับเฟอร์นิเจอร์ (อีกครั้ง)
กลับมาที่ analogy เดิม: Architecture = ขนาดตึก (กี่ชั้น, กี่ห้อง) — ถูกกำหนดในแบบแปลนก่อนสร้าง Training = ขนเฟอร์นิเจอร์เข้าห้อง — ไม่ได้สร้างห้องใหม่
ถ้าคุณอยากได้ตึก 64 ชั้นแทนที่จะเป็น 32 ชั้น? คุณก็แค่เปลี่ยน num_hidden_layers=64 ใน config — ขนาดโมเดลจะเปลี่ยนทันที (เป็น ~15.0 พันล้าน) โดยที่ยังไม่ต้องเทรนเลยแม้แต่วินาทีเดียว — แต่โมเดลใหม่นั้นยังเป็น "ตึกว่างเปล่า" ที่ต้องเทรนตั้งแต่ศูนย์
ทำไมเรื่องนี้ถึงสำคัญ
การเข้าใจว่า "ขนาดถูกกำหนดก่อน" ช่วยให้คุณเข้าใจ trade-off พื้นฐานของ LLM:
- โมเดลใหญ่ (70B+): เก็บความรู้ได้มาก ให้คำตอบที่มีคุณภาพสูงกว่า แต่ต้องใช้ VRAM มหาศาลและทำงานช้ากว่า
- โมเดลเล็ก (7B–14B): คุณภาพอาจด้อยกว่าในบางงาน แต่รันได้บน GPU ใบเดียวหรือแม้แต่บน CPU (ผ่าน llama.cpp — ดูบทที่ 24)
การเลือกขนาดโมเดลไม่ใช่เรื่องของ "training ให้ใหญ่พอ" แต่เป็นเรื่องของ "ออกแบบ architecture ให้เหมาะกับทรัพยากรที่มี"
1.6 ภาพรวมการทำงาน — Preview ทั้งเล่ม
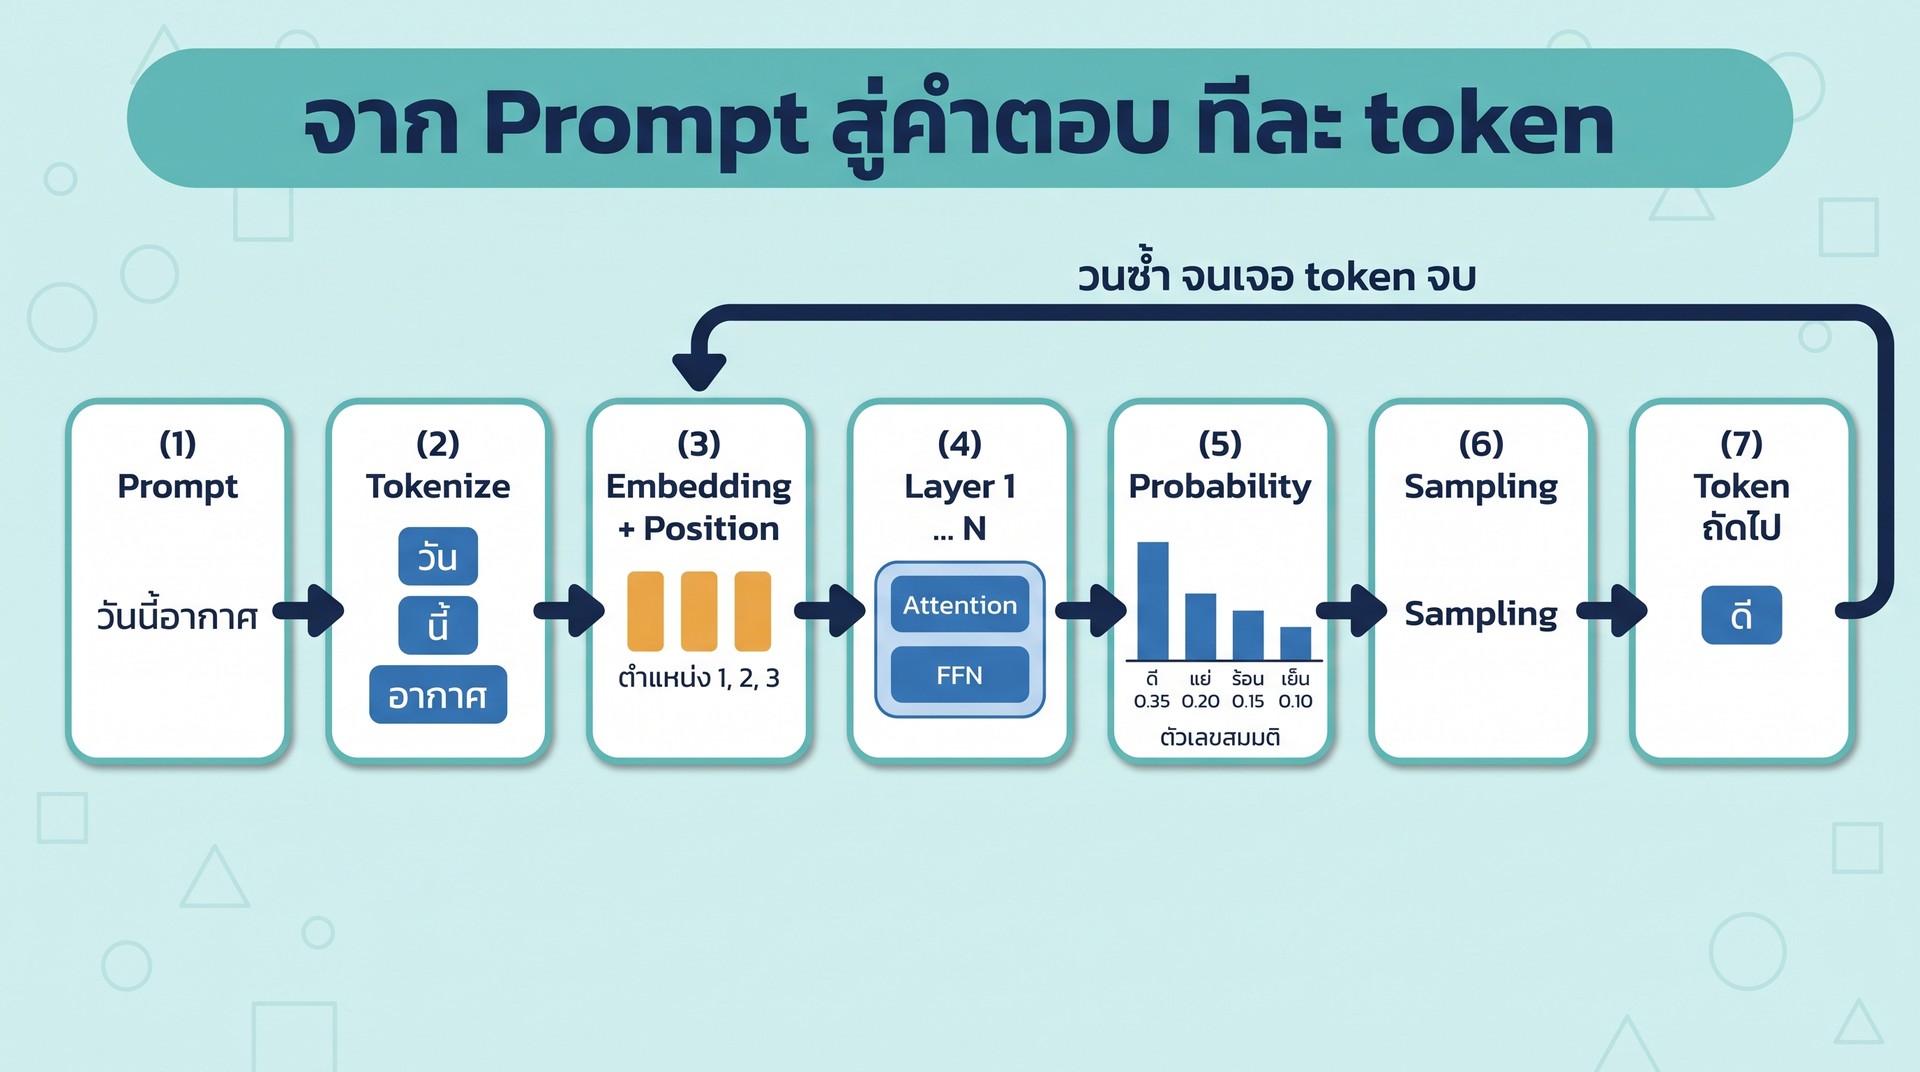
เพื่อให้คุณเห็นภาพใหญ่ก่อนที่เราจะลงรายละเอียดในบทต่อ ๆ ไป นี่คือเส้นทางที่ 1 prompt เดินทางจากแป้นพิมพ์ของคุณไปจนถึงคำตอบ:
Prompt → Tokenize → Embedding + Position →
[Layer 1..N: Attention + FFN] →
Probability Distribution → Sampling → Token ถัดไป → loop
มาดูแต่ละขั้นตอนแบบคร่าว ๆ กัน:
ขั้นที่ 1 — Tokenize (บทที่ 2)
ข้อความที่คุณพิมพ์ เช่น "ท้องฟ้าทำไมถึงเป็นสีฟ้า" จะถูกแตกออกเป็นชิ้นเล็ก ๆ ที่เรียกว่า Tokens — ซึ่งอาจเป็นคำ, ส่วนของคำ, หรือแม้แต่ตัวอักษรเดี่ยว "ท้องฟ้าทำไมถึงเป็นสีฟ้า" อาจกลายเป็นประมาณ ["ท้อง", "ฟ้า", "ทำไม", "ถึง", "เป็น", "สี", "ฟ้า"] — 7 tokens (นี่คือภาพประกอบ จำนวนและรอยตัดจริงขึ้นกับ tokenizer ของแต่ละโมเดล — บทที่ 2 วัดด้วย tokenizer จริง)
ขั้นที่ 2 — Embedding + Position (บทที่ 3–4)
แต่ละ token จะถูกแปลงเป็นเวกเตอร์ (ชุดตัวเลข) ที่มีความหมาย — เรียกว่า Embedding เสร็จแล้วเราจะฉีดข้อมูลตำแหน่งเข้าไปด้วย (Positional Encoding) เพื่อให้โมเดลรู้ว่าคำไหนมาก่อน-หลัง เพราะ Transformer ไม่ได้อ่านทีละคำตามลำดับ (โมเดลสมัยใหม่ที่ใช้ RoPE ไม่ได้บวกตำแหน่งเข้ากับ embedding ตรง ๆ แต่หมุนเวกเตอร์ Q และ K ในทุก layer — บทที่ 4)
ขั้นที่ 3 — Transformer Layers (บทที่ 5–8)
นี่คือส่วน "มันสมอง" ของ LLM — embeddings จะถูกส่งผ่าน Transformer Layers จำนวน N ชั้น (เช่น 32 ชั้นใน Llama-3.1-8B, 80 ชั้นใน Llama-3.1-70B) แต่ละชั้นประกอบด้วยสองกลไกหลัก:
- Attention (บทที่ 6): กลไกที่ให้โมเดล "ใส่ใจ" ว่าคำไหนสัมพันธ์กับคำไหน — เช่น "มัน" ในประโยคหมายถึง "แมว" หรือ "ปลา"?
- Feed-Forward Network หรือ FFN (บทที่ 7): กลไกที่ประมวลผลและ "คิด" เกี่ยวกับข้อมูล — นี่คือที่ที่ "ความรู้" ของโมเดลถูกเก็บไว้
ขั้นที่ 4 — Probability Distribution (บทที่ 9)
เมื่อข้อมูลผ่านทุก layer แล้ว LLM จะสร้าง probability distribution — ตารางความน่าจะเป็นของทุก token ใน vocabulary (ราว 128,000–260,000 ตัว ขึ้นกับโมเดล: Llama-3.1 มี 128,256, Gemma 4 มี 262,144) ตัวอย่างด้านล่างเป็นค่าจริงที่วัดจาก Llama-3.1-8B-Instruct (BF16) เมื่อป้อนข้อความดิบ The capital of France is โดยไม่ผ่าน chat template (ที่มาและวิธีรันอยู่ในบทที่ 27):
P(" a")       = 0.2098
P(" Paris")   = 0.1852
P(" known")   = 0.0725
P(" home")    = 0.0681
P(" the")     = 0.0388
...  (อีก 128,251 token ที่เหลือ รวมกันราว 0.43)
สังเกตว่า " Paris" ไม่ได้ชนะเสมอไป เพราะโมเดลกำลังต่อ "ข้อความ" ไม่ได้ถูกถามคำถาม — token ที่ได้ความน่าจะเป็นสูงสุดคือ " a" (ต่อเป็น "a city of …") ส่วนภาพด้านล่างใช้ตัวเลขสมมติเพื่อให้เห็นขั้นตอนเท่านั้น
ขั้นที่ 5 — Sampling (บทที่ 9)
LLM เลือก token ถัดไปจาก probability distribution — ไม่จำเป็นต้องเลือกตัวที่มี probability สูงสุดเสมอไป (นั่นคือที่มาของความหลากหลายของคำตอบ) จากนั้น token ที่ถูกเลือกจะถูกป้อนกลับเข้าไปในขั้นที่ 2–5 เพื่อ generate token ถัดไป — ทำซ้ำจนกว่าจะเจอ token "จบประโยค"
1.7 วิธีอ่านหนังสือเล่มนี้
หนังสือเล่มนี้ถูกออกแบบให้อ่านเรียงลำดับจากบทที่ 1 ถึงบทที่ 27 — แต่ละบท build on ความรู้จากบทก่อนหน้า:
ส่วนที่ 1 — รู้จัก LLM (บทที่ 1–4): เราจะเริ่มจากภาพรวม และเรียนรู้ว่าข้อความถูกแปลงเป็นตัวเลขที่โมเดลเข้าใจได้อย่างไร — Tokens, Embedding, Positional Encoding
ส่วนที่ 2 — เปิดฝา Transformer (บทที่ 5–8): นี่คือหัวใจของหนังสือ — เราจะเปิดดูกลไกภายในของ Transformer ทีละชิ้น: Architecture, Attention, FFN, และกระบวนการ Training ที่สร้าง weights ทั้งหมด
ส่วนที่ 3 — การ Generate (บทที่ 9–10): เราเปลี่ยนจาก "โมเดลทำงานยังไง" เป็น "โมเดลสร้างคำตอบยังไง" — เรียนรู้การสุ่มเลือก token (Sampling) และ KV Cache กับ context ยาว ๆ ที่ทำให้ generate เร็วพอใช้งานได้จริง
ส่วนที่ 4 — ควบคุม Output (บทที่ 11–14): เรียนรู้วิธีควบคุม LLM ให้ตอบตามที่เราต้องการ — Prompt & Context Engineering (บทที่ 11), RAG (บทที่ 12), Thinking Models (บทที่ 13) และ Agents, Tool Calling และ MCP (บทที่ 14) ที่ให้ LLM ลงมือทำงานแทนแค่ตอบ
ส่วนที่ 5 — ลงมือปฏิบัติ (บทที่ 15–26): หลังจากเข้าใจทฤษฎีทั้งหมด เราจะลงมือทำจริง — Continued Pretraining, การเลือกโมเดล, Fine-Tuning, Alignment, Quantization, Distillation, MoE, Speculative Decoding, Multi-GPU, Inference Engines, Safety และการวัดผล
ส่วนที่ 6 — บทสรุป (บทที่ 27): เราเชื่อมโยงทุกอย่างเข้าด้วยกัน — ย้อนดู 1 prompt ตั้งแต่ต้นจนจบอีกครั้ง แต่ครั้งนี้คุณจะเข้าใจทุกขั้นตอน และเรียนรู้วิธีตามให้ทันเมื่อข้อมูลเปลี่ยน
เคล็ดลับ: ถ้าคุณมีพื้นฐานมาบ้างแล้ว สามารถข้ามไปอ่านบทที่สนใจได้ทันที — ถ้าคุณเจอ concept ที่ยังไม่เข้าใจ จะมีข้อความแนะนำว่า "(ดูบทที่ X)" ให้ย้อนกลับไปอ่าน
ข้อตกลงของหนังสือฉบับนี้: ตัวเลขที่คำนวณได้ทุกตัวในหนังสือ (จำนวน parameters, ขนาดหน่วยความจำ, จำนวน token, ค่า softmax ฯลฯ) ถูกคำนวณด้วยสคริปต์ที่รันซ้ำได้ ส่วนข้อมูลที่เปลี่ยนเร็ว (ชื่อรุ่น, ราคา, license) มีวันที่ตรวจกำกับ — ถ้าเห็นว่าเก่าแล้ว ให้ถือวันที่เป็นตัวตัดสิน
1.8 สรุปบทที่ 1
- LLM (Large Language Model) คือ neural network ขนาดใหญ่ที่ถูกเทรนให้ทำนายคำถัดไป — ความสามารถทั้งหมดตั้งแต่แต่งกลอนจนถึงเขียนโค้ดมาจากหลักการพื้นฐานนี้
- LLM มีสององค์ประกอบที่แยกจากกัน: Architecture (โครงสร้าง — เหมือนแบบแปลนตึก) และ Weights (ตัวเลขความรู้ — เหมือนเฟอร์นิเจอร์ในตึก)
- Parameters คือจำนวน weights ทั้งหมดในโมเดล — ยิ่งมากยิ่งเก็บความรู้ได้มาก แต่ต้องใช้ VRAM มากขึ้นตาม (7B ที่ 16 บิต ≈ 14 GB) โมเดล MoE ต้องเก็บ parameters ทั้งหมดแต่ใช้แค่บางส่วนต่อ token
- ขนาดโมเดลถูกกำหนดก่อน training เริ่ม — คำนวณได้จาก config (Llama-3.1-8B = 8.03 พันล้าน) training แค่เติมตัวเลขลงในโครงสร้างที่มีอยู่แล้ว ไม่ได้สร้าง parameters ใหม่
- ขนาดของโมเดลปิด (เช่น GPT-4) ไม่ได้เปิดเผย — ตัวเลขที่เห็นตามสื่อเป็นข่าวลือ
- เส้นทางการทำงานของ LLM: Prompt → Tokenize → Embedding → Transformer Layers (Attention + FFN) → Probability Distribution → Sampling → Token ต่อไป
- หนังสือเล่มนี้จะพาคุณเจาะลึกทุกขั้นตอนนี้ ทีละขั้น — โดยใช้ analogy และภาพประกอบเพื่อให้เข้าใจได้โดยไม่ต้องมีพื้นฐานคณิตศาสตร์
แหล่งอ้างอิง
- Vaswani et al., "Attention Is All You Need" (2017) — ต้นกำเนิด Transformer architecture
- ที่มา: https://arxiv.org/abs/1706.03762
- Jay Alammar, "The Illustrated Transformer" — คำอธิบาย Transformer ด้วยภาพ
- ที่มา: https://jalammar.github.io/illustrated-transformer/
- Touvron et al., "LLaMA: Open and Efficient Foundation Language Models" (2023)
- ที่มา: https://arxiv.org/abs/2302.13971
- Dubey et al., "The Llama 3 Herd of Models" (2024) — hyperparameters ของ Llama 3 (Table 3)
- ที่มา: https://arxiv.org/abs/2407.21783
- OpenAI, "GPT-4 Technical Report" (2023) — ระบุว่าไม่เปิดเผยขนาดและสถาปัตยกรรม
- ที่มา: https://arxiv.org/abs/2303.08774
- Reuters (via Taipei Times), "ChatGPT sets record for fastest-growing user base" (2023-02-03) — ประมาณการของ UBS
- ที่มา: https://www.taipeitimes.com/News/biz/archives/2023/02/03/2003793608
- The Decoder, "GPT-4 architecture, datasets, costs and more leaked" (2023) — ต้นตอข่าวลือ 1.76T
- ที่มา: https://the-decoder.com/gpt-4-architecture-datasets-costs-and-more-leaked/
- ตัวเลขที่คำนวณทั้งบท: สคริปต์ประกอบหนังสือ
ข้อมูลตรวจเมื่อ 2026-10-11 (ตารางโมเดลในหัวข้อ 1.4 และข้อมูล ChatGPT)